RAG Knowledge Base untuk Perusahaan: Kapan Arsitektur Event-Driven Dibutuhkan?
RAG Knowledge Base untuk Perusahaan: Kapan Arsitektur Event-Driven Dibutuhkan?
Sistem RAG (Retrieval Augmented Generation) mengubah cara perusahaan mengelola informasi. Alih-alih sekadar menyimpan dokumen, sistem ini memungkinkan karyawan mencari jawaban spesifik dari ribuan halaman SOP, kontrak, atau manual teknis dalam hitungan detik. Namun, ketika volume data terus bertambah dan sumber dokumen tersebar di banyak sistem, arsitektur RAG knowledge base sederhana dengan sinkronisasi batch mulai menemui batasnya. Di titik ini, arsitektur event-driven menjadi solusi yang perlu dipertimbangkan.
Keterbatasan RAG Sinkronus Tradisional Lihat juga portfolio Solunesia.
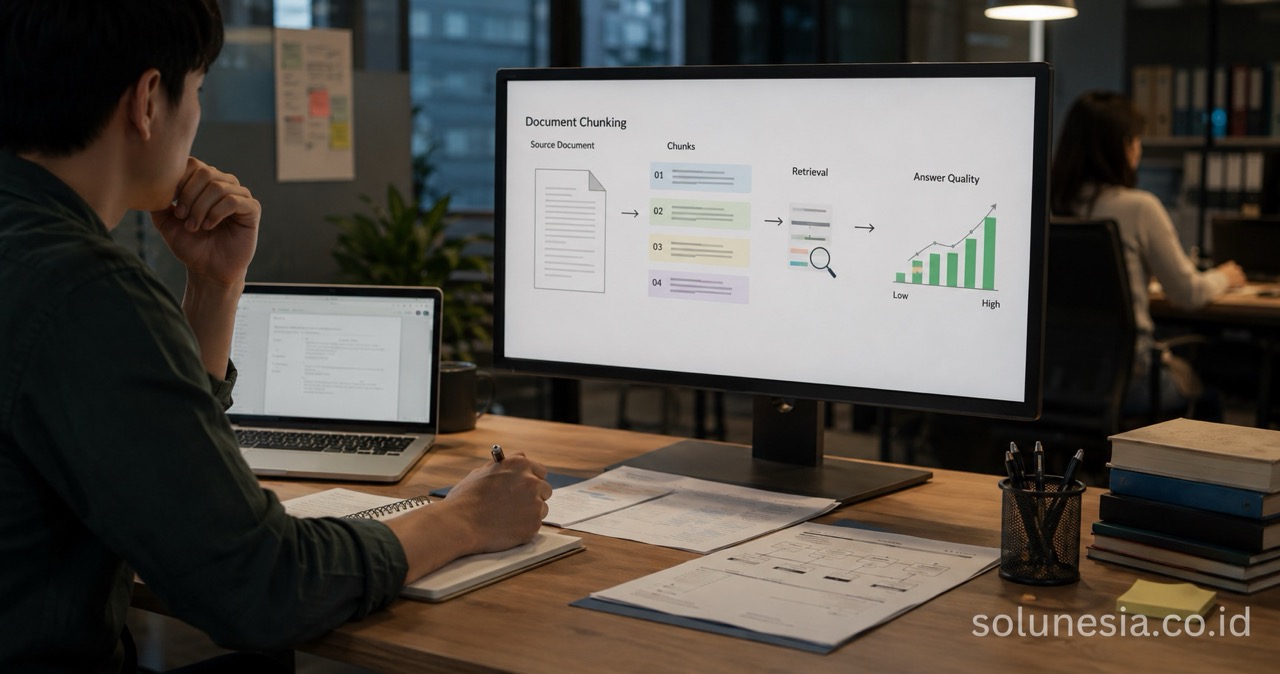
Pendekatan paling umum saat membangun RAG knowledge base adalah menjadwalkan proses indexing secara berkala. Misalnya, sebuah cron job berjalan setiap tengah malam untuk memindai folder Google Drive atau SharePoint, mengekstrak teksnya, memecahnya menjadi potongan (chunking), lalu menyimpan embedding ke vektor database. Untuk perusahaan dengan ratusan dokumen yang jarang berubah, metode ini memang sudah cukup.
Masalah muncul ketika data bersifat dinamis. Bayangkan sebuah perusahaan manufaktur di Batam yang memiliki standar operasional, laporan inspeksi mutu harian, dan dokumen kepatuhan yang terus diperbarui sepanjang hari kerja. Jika ada insiden di lantai produksi pukul 09:00 pagi dan laporannya baru diindeks pukul 01:00 dini hari, sistem RAG tidak akan mengetahui dokumen tersebut jika ditanya pukul 10:00. Karyawan bisa mendapatkan jawaban yang kedaluwarsa atau meleset dari standar mutu terbaru.
Selain itu, proses pemindaian massal secara berkala sangat boros komputasi. Sistem harus memproses ulang seluruh folder meskipun hanya satu dokumen yang berubah. Hal ini membebani API pembuat embedding (seperti OpenAI atau model open-source lokal) dan memperlambat pipeline secara keseluruhan.
Berikut beberapa keterbatasan utama yang sering muncul:
- Keterlambatan update dokumen: Proses batch berjalan hanya pada waktu tertentu, sehingga jawaban AI bisa tidak akurat untuk data yang baru dimasukkan.
- Pemborosan sumber daya: Setiap kali jadwal berjalan, sistem memindai semua dokumen meski hanya sedikit yang berubah.
- Risiko kesalahan konsistensi: Dokumen dari sumber berbeda bisa memiliki versi yang tidak sinkron, menyebabkan jawaban yang tidak konsisten.
- Kompleksitas integrasi: Sulit menggabungkan data dari banyak sistem tanpa menambah lapisan penjadwalan yang rumit.
Kapan Perusahaan Membutuhkan Arsitektur Event-Driven
Arsitektur event-driven dalam RAG berarti pembaruan indeks dipicu oleh perubangan status dokumen (event), bukan oleh jadwal waktu. Ketika seorang karyawan menyimpan file baru, mengedit paragraf, atau menghapus lampiran di sistem file manajemen, sistem langsung memancarkan event. Konsumen (worker) yang mendengarkan event tersebut akan segera mengambil dokumen yang relevan, memprosesnya, dan memperbarui vektor database.
Tiga kondisi utama menentukan kapan perusahaan perlu beralih ke arsitektur ini:
-
Frekuensi Pembaruan Data yang Tinggi
Sistem yang sumber datanya berubah setiap menit atau jam tidak bisa menunggu proses batch harian. Contoh nyata ada pada sistem pelayanan publik. Dalam pengembangan sistem perpustakaan DPK Kepri yang mengelola lebih dari 27.000 judul, katalog digital harus selalu sinkron secara real-time. Jika ada penambahan koleksi baru oleh staf, sistem pelacakan harus segera mengenalinya. Pendekatan event-driven memastikan perubahan ini langsung terindeks tanpa harus menunggu pemindaian penuh. -
Kebutuhan Real-Time untuk Keputusan Kritis
Beberapa industri tidak toleran terhadap informasi tertinggal. Di sektor fintech, seperti sistem pinjaman KSP Finance yang mengintegrasikan OCR dan multi-currency, keputusan kredit dan analisis dokumen kepatuhan harus berdasarkan data paling mutakhir. Jika RAG digunakan untuk membantu analis meninjau syarat pinjaman terbaru dari regulator, dokumen regulasi yang baru diunggah harus langsung masuk ke knowledge base. Arsitektur event-driven menjamin ketersediaan informasi saat dibutuhkan. -
Sumber Data Tersebar (Distributed Sources)
Perusahaan skala enterprise jarang menyimpan semua aset digital di satu tempat. Dokumen bisa tersebar di ERP, intranet perusahaan, sistem HR, atau aplikasi CRM eksternal. Menggabungkan semua sumber ini ke dalam satu penjadwalan batch tunggal menciptakan titik kegagalan tunggal (single point of failure) dan kompleksitas integrasi yang tinggi. Event-driven memungkinkan setiap sistem bertindak mandiri, memancarkan webhook atau pesan antrian (seperti RabbitMQ atau Kafka) begitu status internalnya berubah.
Komponen Utama dalam Arsitektur Event-Driven RAG
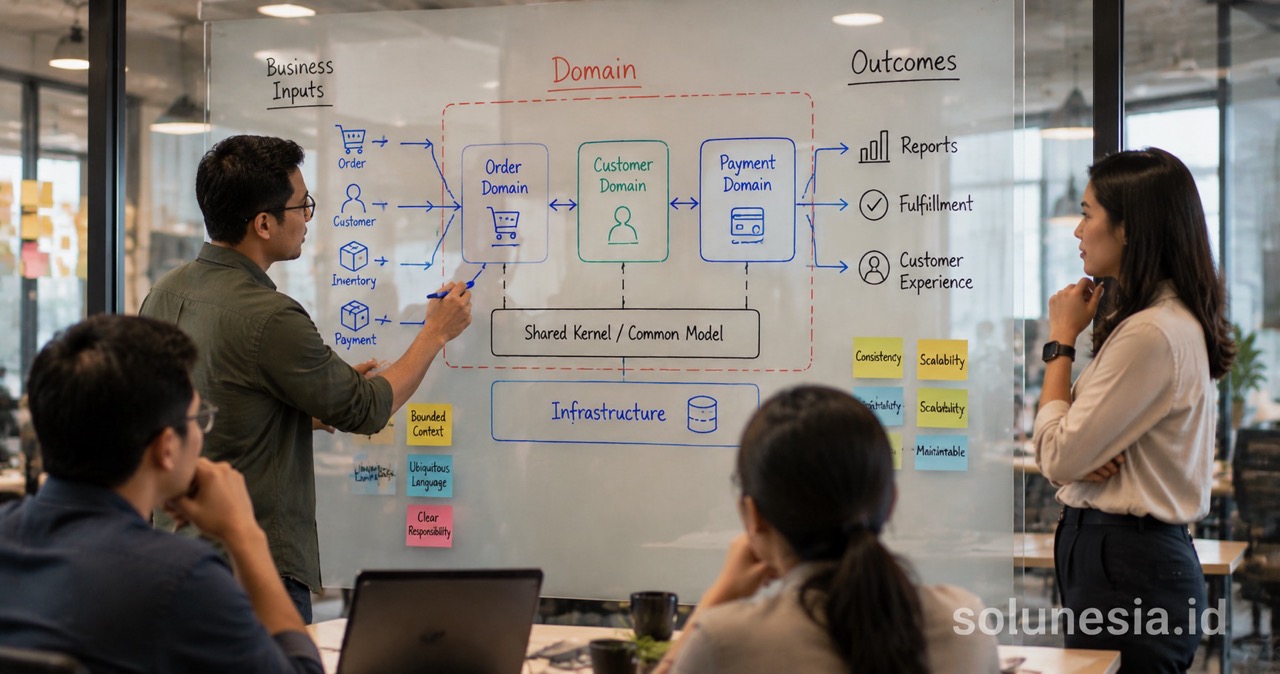
Membangun sistem RAG yang dipicu oleh event memerlukan beberapa lapisan infrastruktur yang berbeda dari RAG konvensional. Sebagai pengambil keputusan teknis, penting untuk memahami anatomi sistem ini agar tidak membangun abstraksi yang tidak perlu.
-
Event Producers
Ini adalah titik awal di mana perubahan terdeteksi. Bisa berupa webhook dari SharePoint saat file diunggah, trigger database saat record diperbarui, atau listener sistem file di server internal. Produsen ini tidak boleh dibebani logika bisnis RAG. Tugasnya hanya mengirimkan notifikasi: “Dokumen X telah berubah”. Prinsip YAGNI berlaku di sini: jangan tambahkan logika parsing teks atau chunking di sisi produsen. Biarkan tugas itu kepada spesialis. -
Message Queue / Event Bus
Notifikasi dari berbagai produsen dikumpulkan ke dalam antrian terpisah (decoupling). Antrian ini berfungsi sebagai peredam (buffer) ketika ada lonjakan pembaruan dokumen secara bersamaan. Alih-alih memproses seratus dokumen sekaligus dan membuat server lumpuh, antrian mendistribusikan beban secara teratur. Integrasi antrian pesan memungkinkan ketahanan sistem tetap terjaga meskipun volume naik. -
Event Consumers / Workers
Worker adalah komponen yang mendengarkan antrian dan melakukan pekerjaan berat. Saat menerima event, worker mengambil dokumen asli, membersihkan teksnya, melakukan chunking sesuai strategi token, memanggil API embedding, dan menyimpan vektor ke database. -
Vector Store dan Metadata Index
Vektor yang dihasilkan disimpan di database semantik, sementara metadata (seperti tanggal pembaruan, ID departemen, status dokumen) disimpan bersamaannya. Ketika sistem RAG menerima pertanyaan, sistem tidak hanya mencari kesamaan semantik tetapi juga memfilter berdasarkan metadata terbaru yang disinkronisasi melalui event.
Risiko dan Pertimbangan Implementasi
Migrasi ke arsitektur event-driven bukan tanpa risiko. Salah satu kesalahan paling umum adalah over-engineering sejak awal. Tidak semua knowledge base membutuhkan Kafka dan cluster worker yang kompleks. Jika perusahaan hanya memiliki seratus dokumen kebijakan HR yang diperbarui setiap kuartal, skrip Python sederhana berbasis jadwal sudah lebih dari cukup. Menambahkan event broker hanya akan menambah biaya server dan beban DevOps tanpa manfaat yang sepadan.
Berikut beberapa risiko utama yang perlu dipertimbangkan:
-
Over-engineering pada skala kecil
Menambahkan kompleksitas event broker untuk volume data rendah hanya meningkatkan biaya tanpa manfaat. -
Masalah keterurutan dan duplikasi
Jika satu dokumen diubah dua kali dalam hitungan detik, worker bisa memproses versi lama setelah versi baru, mengakibatkan indeks tertinggal. Solusinya, setiap event harus membawa ID unik dan versi timestamp untuk mencegah race condition. -
Isu keamanan data sensitif
Dalam arsitektur terdistribusi, data mengalir melalui antrian antar layanan. Misalnya, jika perusahaan logistik mengembangkan sistem RAG untuk kontrak pengiriman multi-gudang, data harga kontrak tidak boleh bocor ke worker yang tidak berwenang. Solusi praktisnya adalah menerapkan enkripsi payload di level antrian dan memastikan kontrol akses berbasis peran (role-based access control) diterapkan di setiap titik integrasi. Anda dapat mempelajari penerapan praktik keamanan serupa pada layanan sistem manajemen gudang yang juga membutuhkan integrasi ketat antar modul.
Kesimpulan
Arsitektur event-driven dalam RAG knowledge base bukanlah kemewahan, melainkan jawaban spesifik untuk skenario di mana kecepatan pembaruan data dan keandalan informasi bersinggungan langsung dengan operasional bisnis. Jika operasional perusahaan Anda bergantung pada dokumen yang berubah setiap jam, tersebar di banyak platform, dan digunakan untuk keputusan kritis, saatnya meninggalkan pemrosesan batch. Namun, jika volume data kecil dan statis, pendekatan sederhana akan selalu menjadi pilihan yang paling logis.
Mengembangkan sistem RAG yang stabil memerlukan pemahaman menyeluruh tentang arsitektur data perusahaan, bukan sekadar memanggil API AI. Jika ingin mendiskusikan rancangan arsitektur knowledge base yang sesuai dengan skala dan kebutuhan dokumen perusahaan Anda, tim Solunesia dapat memberikan konsultasi teknis melalui halaman kontak kami.
FAQ
Kapan waktu yang tepat untuk beralih dari cron job ke event-driven di RAG?
Saat dokumen sumber berubah berkali-kali dalam satu hari dan karyawan membutuhkan jawaban dari dokumen terbaru secara real-time. Jika data hanya diperbarui bulanan, cron job tetap lebih hemat biaya dan efisien.
Apakah event-driven RAG membutuhkan biaya cloud lebih besar?
Biaya awal memang lebih tinggi karena melibatkan antrian pesan dan worker terpisah. Namun untuk skala besar, sistem ini berpotensi menghemat biaya karena proses embedding hanya berjalan saat dokumen berubah, bukan memindai seluruh basis data setiap hari.
Bagaimana cara mencegah dokumen duplikat di indeks vektor?
Setiap event harus menyertakan ID dokumen unik. Sebelum worker melakukan embedding, sistem harus memeriksa ID tersebut di vektor database. Jika sudah ada, worker melakukan upsert atau memperbarui data lama, bukan menambah entri baru.
Apakah semua LLM mendukung integrasi event-driven?
Ya. LLM menerima input teks, terlepas dari bagaimana teks tersebut masuk ke vektor database. Event-driven berfokus pada arsitektur pembaruan indeks sebelum teks dikirim ke LLM, sehingga kompatibel dengan model AI apa pun.
Apakah Solunesia pernah membangun sistem pencarian dokumen skala besar?
Ya, salah satu contohnya adalah sistem katalog DPK Kepri yang mengelola lebih dari 27.000 judul, memerlukan pembaruan data yang cepat dan akurat, membuktikan kapabilitas pengembangan sistem informasi skala enterprise.
RelatedArticles
Further reading from other categories that may be relevant.
Semantic Search untuk Dokumen Perusahaan: Kapan Lebih Berguna dari Pencarian Biasa?
Chatbot Dokumen dengan RAG: Cocokkah untuk Knowledge Base Perusahaan?