Chunking pada RAG: Mengapa Struktur Dokumen Mempengaruhi Kualitas Jawaban?
Chunking pada RAG: Mengapa Struktur Dokumen Mempengaruhi Kualitas Jawaban?
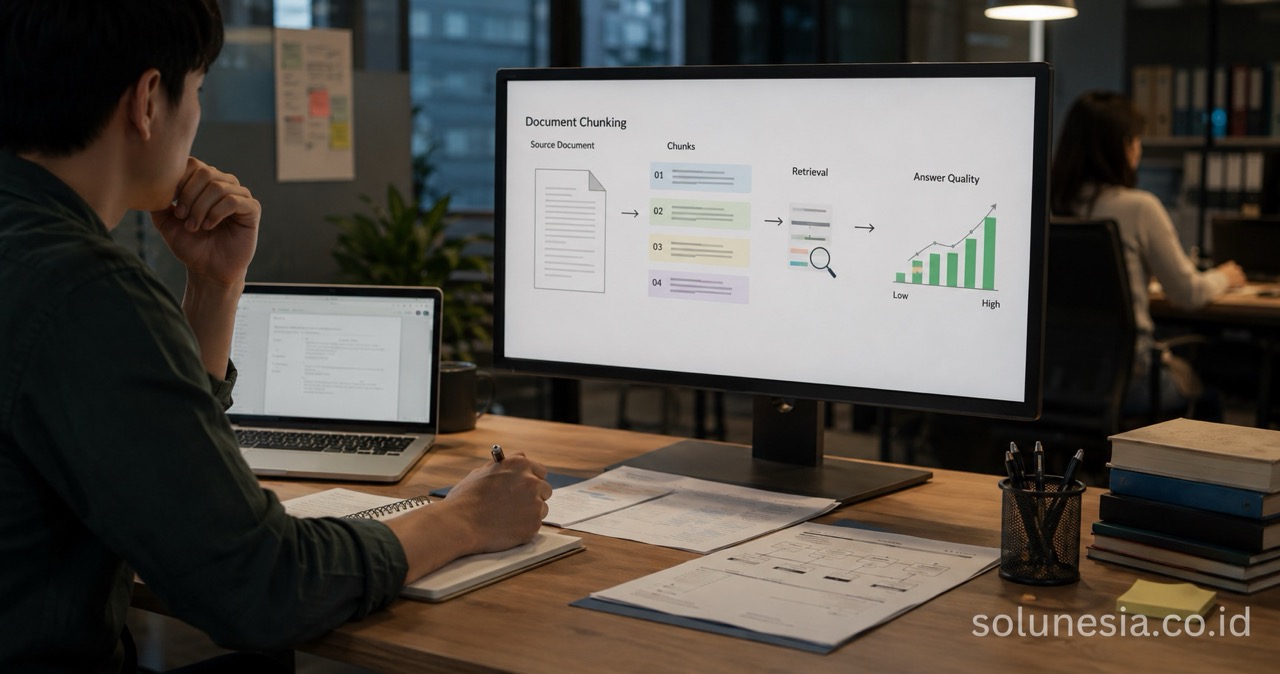
Membangun sistem Retrieval-Augmented Generation (RAG) seringkali terhenti di satu masalah: jawaban AI yang tidak akurat. Akar masalahnya jarang terletak pada model bahasa yang dipilih, melainkan pada cara dokumen dipotong sebelum masuk ke database vektor. Strategi chunking pada RAG menentukan apakah sistem menemukan konteks yang tepat atau sekadar menebak berdasarkan potongan informasi yang kehilangan makna.
Sebagai pengambil keputusan teknis, memahami bagaimana data perusahaan dipecah menjadi sangat penting. Pendekatan ini langsung memengaruhi kualitas jawaban, biaya inferensi, dan kepercayaan pengguna terhadap sistem AI yang dibangun. Lihat juga portfolio Solunesia. Pelajari juga blog Solunesia.
Mengapa Ukuran Potongan Tidak Bisa Ditetapkan Secara Asal?
Pendekatan paling naif dalam membangun knowledge base adalah memotong teks berdasarkan jumlah karakter tetap, misalnya 1.000 token per potongan. Praktik ini sering menyebabkan informasi penting terbelah di tengah kalimat atau paragraf.
Bayangkan sebuah kontrak kerja sama di mana klausa penalti dipotong di tengah. Potongan pertama berisi syarat, potongan kedua berisi besaran denda. Saat pengguna bertanya tentang penalti, sistem mungkin hanya mengambil potongan kedua tanpa konteks syarat yang memuat kondisinya. Hasilnya, jawaban AI menjadi ambigu atau keliru.
Model bahasa membutuhkan konteks yang utuh secara semantik untuk menalar jawaban. Ketika potongan teks kehilangan struktur konseptualnya, Model akan mulai berhalusinasi. Potongan yang terlalu kecil kehilangan konteks, sementara potongan yang terlalu besar mendilusi kepadatan informasi, menurunkan akurasi pencarian semantik. Tidak ada angka ajaib untuk ukuran ini; strategi chunking yang tepat selalu mengikuti format dan semantik dokumen sumbernya.
Kapan fixed-size chunking paling cocok digunakan?
- Dokumen yang sangat terstruktur seperti kode program atau log data.
- Sistem dengan budget terbatas untuk penyimpanan vektor.
- Proyek awal yang ingin cepat diuji sebelum dioptimalkan.
Kapan lebih baik menghindari fixed-size chunking?
- Dokumen legal atau SOP yang bergantung pada urutan kalimat.
- Kasus di mana satu ide penting terbelah menjadi dua potongan.
- Organisasi yang membutuhkan jawaban akurat untuk pertanyaan kompleks.
Relevansi Semantik vs Pemecahan Statik
Pemecahan statik (fixed-size chunking) memang cepat dan murah untuk diimplementasikan. Namun, dokumen perusahaan tidak pernah datang dalam format yang seragam. Spesifikasi teknis, dokumen legal, dan manual prosedur memiliki struktur berbeda.
Strategi chunking pada RAG yang lebih baik mengandalkan struktur dokumen itu sendiri. Alih-alih memotong berdasarkan jumlah kata, sistem harus memahami hierarki: judul, sub-judul, paragraf, dan daftar. Pemecahan semantik memastikan satu potongan mewakili satu ide lengkap.
Misalnya, pada dokumen kebijakan Sumber Daya Manusia perusahaan, setiap sub-bagian tentang “Cuti Tahunan” harus menjadi satu unit informasi. Jika sistem hanya memotong berdasarkan panjang teks, aturan cuti bisa bercampur dengan kebijakan tunjangan kesehatan di dalam satu potongan vektor yang sama. Saat karyawan bertanya tentang sisa cuti, algoritma pencarian vektor akan kesulitan membedakan mana relevansi utama dan mana yang hanya teks pengiring. Memisahkan berdasarkan batas semantik memberikan sinyal yang jelas kepada sistem retrieval.
Keunggulan pemecahan semantik dibandingkan statis:
- Satu potongan mewakili satu konsep utuh tanpa terpotong.
- Mengurangi kemungkinan model berhalusinasi karena kehilangan konteks.
- Lebih mudah memahami hierarki dokumen seperti bab dan pasal.
- Memberikan hasil pencarian yang lebih presisi untuk pertanyaan spesifik.
Tantangan pada Format Tabel dan Dokumen Terstruktur
Dokumen enterprise nyata jarang berupa teks naratif murni. Laporan keuangan, spesifikasi produk, dan dokumen kepatuhan mengandung tabel. Pemotongan standar berdasarkan teks linear akan menghancurkan struktur tabel, mengubahnya menjadi data yang kehilangan relasi kolom.
Dalam dokumen yang memuat tabel, strategi chunking yang baik harus mengekstrak tabel dan menyimpannya sebagai format terstruktur seperti Markdown atau JSON sebelum dipotong. Beberapa sistem tingkat lanjut bahkan menambahkan ringkasan teks dari tabel tersebut ke dalam metadata, sehingga pencarian semantik bisa menemukan tabel tersebut berdasarkan deskripsi, lalu mengembalikan data tabel yang utuh kepada Model sebagai konteks.
Proses ini seringkali melibatkan pemrosesan dokumen OCR jika file sumber berupa hasil pindai. Solunesia telah menangani kasus serupa pada sistem fintech lintas negara, di mana ekstraksi data dari dokumen fisik harus akurat sebelum bisa diolah oleh sistem AI lebih lanjut. Tanpa pemisahan elemen non-teks yang baik, jawaban Model untuk pertanyaan numerik akan sangat tidak dapat diandalkan.
Contoh bagaimana tabel terpecah buruk:
- Klausa “Total biaya: Rp 50 juta” terpotong di tengah, sehingga model tidak tahu angka lengkapnya.
- Kolom “Kode” dan “Deskripsi” bercampur dengan data lain di dalam satu potongan.
- Relasi antar baris tabel hilang, membuat model tidak bisa menyimpulkan ringkasan laporan.
Mempertahankan Konteks Lintas Potongan dengan Overlap
Saat sebuah ide panjang terbelah, konteks bisa mengalir dari satu potongan ke potongan lain. Ini disebut overlap. Jika potongan A berisi 500 token, potongan B berikutnya mungkin berisi 100 token terakhir dari potongan A sebelum melanjutkan ke teks baru. Tujuannya adalah memberi jendela konteks bersama antar potongan yang berdekatan.
Namun, menambahkan overlap berarti meningkatkan total volume penyimpanan vektor dan biaya pencarian. Semakin besar overlap, semakin banyak data duplikat yang diindeks. Pada sistem knowledge base skala enterprise dengan ratusan ribu dokumen, ini berdampak langsung pada biaya infrastruktur database vektor.
Pilihan alternatif adalah menyimpan metadata hierarki pada setiap potongan. Alih-alih mengandalkan overlap teks yang boros ruang, setiap potongan disimpan bersama informasi seperti “Bab 3, Bagian 2.1”. Saat pencarian menemukan potongan tertentu, sistem bisa secara cerdas mengambil potongan tetangga berdasarkan metadata hierarki ini. Pendekatan ini membutuhkan arsitektur yang lebih matang tetapi jauh lebih efisien untuk skala besar.
Dua pendekatan utama untuk mempertahankan konteks:
- Overlap teks: Memberi jendela kontekstual langsung antar potongan, cocok untuk dokumen naratif panjang.
- Metadata hierarki: Menyimpan informasi struktur seperti nomor bab atau pasal, lebih hemat ruang dan fleksibel.
Penanganan Metadata dan Penyimpanan Cerdas
Potongan teks yang mendarat di database vektor tidak boleh kosong tanpa identitas. Metadata adalah pembeda utama antara sistem RAG dasar dengan sistem yang layak untuk enterprise. Menyimpan informasi seperti nomor revisi dokumen, tanggal berlaku, departemen pemilik, dan tingkat akses penting untuk memfilter hasil pencarian sebelum dikirim ke Model.
Pertimbangkan skenario di manajer operasional di Batam mencari prosedur keselamatan kerja. Sistem harus mampu memfilter dan hanya mengambil potongan dari dokumen SOP versi terbaru, mengabaikan versi lama yang sudah kadaluarsa. Tanpa filter metadata yang kuat, Model akan menerima instruksi kerja dari tahun lalu yang mungkin sudah tidak sesuai regulasi. Di lingkungan industri yang teregulasi ketat, memberikan jawaban dari dokumen yang sudah usang bukan sekadar ineffisiensi, melainkan risiko compliance.
Jenis metadata yang perlu disimpan:
- Nomor revisi dan tanggal pembaruan dokumen.
- Departemen atau unit organisasi pemilik konten.
- Tingkat aksesibilitas (misalnya hanya untuk tim keuangan).
- Status kepatuhan seperti “berlaku hingga tanggal tertentu”.
Kesimpulan: Fondasi dari Jawaban yang Akurat
Kualitas jawaban sistem RAG tidak pernah melampaui kualitas konteks yang diberikan. Model bahasa terbaik sekalipun tidak bisa menghasilkan jawaban akurat jika data masukannya sudah terpotong sembarangan dan kehilangan makna. Memilih strategi chunking yang menghormati struktur dokumen, menangani tabel dengan tepat, dan memanfaatkan metadata secara cerdas adalah fondasi utama untuk membangun sistem AI yang dapat dipercaya.
Membangun fondasi ini memerlukan ketelitian dalam memahami arsitektur informasi perusahaan. Jika organisasi Anda sedang mengevaluasi penerapan sistem pengetahuan internal atau menghadapi masalah akurasi pada implementasi AI yang sudah berjalan, berdiskusi dengan tim ahli adalah langkah awal yang tepat. Hubungi tim konsultasi Solunesia untuk merancang strategi pengolahan data yang sesuai dengan kebutuhan spesifik bisnis Anda. Untuk mendiskusikan kebutuhan serupa di organisasi Anda, hubungi tim Solunesia atau pelajari layanan pengembangan software kami.
FAQ
Apa itu chunking dalam sistem RAG?
Chunking adalah proses memecah dokumen panjang menjadi potongan-potongan teks yang lebih kecil sebelum disimpan ke database vektor. Ini menentukan bagian mana dari dokumen yang akan diambil sebagai konteks untuk menjawab pertanyaan pengguna.
Apakah strategi chunking berpengaruh pada biaya operasional AI?
Ya, sangat berpengaruh. Potongan yang terlalu panjang atau penggunaan overlap berlebihan meningkatkan kebutuhan penyimpanan vektor dan biaya inferensi model karena token yang diproses menjadi lebih banyak.
Apa dampak jika tabel pada dokumen ikut terpotong secara teks biasa?
Tabel yang terpotong akan kehilangan relasi antar dan kolom. Akibatnya, model AI kehilangan konteks data terstruktur dan berpotensi memberikan jawaban numerik atau faktual yang salah.
Bagaimana cara terbaik memotong dokumen legal atau SOP perusahaan?
Gunakan pemecahan semantik berdasarkan struktur bawaan dokumen, seperti batas bab, pasal, atau sub-judul. Setiap potongan harus mewakili satu ide atau aturan yang utuh agar konteksnya tidak terputus di tengah kalimat.
Kapan sistem perlu mempertimbangkan metadata pada chunking?
Hampir selalu, terutama untuk dokumen enterprise. Metadata membantu sistem memfilter dokumen berdasarkan versi, tanggal pembaruan, atau akses departemen, sehingga AI hanya membaca informasi yang paling relevan dan terkini.
RelatedArticles
Further reading from other categories that may be relevant.
RAG Knowledge Base untuk Perusahaan: Kapan Arsitektur Event-Driven Dibutuhkan?
Fitur Penting Website Perusahaan Modern yang Perlu Diprioritaskan