Semantic Search untuk Dokumen Perusahaan: Kapan Lebih Berguna dari Pencarian Biasa?
Semantic Search untuk Dokumen Perusahaan: Kapan Lebih Berguna dari Pencarian Biasa?
Pencarian kata kunci sudah menjadi standar di hampir semua sistem dokumen. Namun ketika basis data perusahaan membesar, pendekatan pencocokan kata literal sering kali gagal menemukan informasi yang sebenarnya ada. Di titik ini, semantic search knowledge base menjadi solusi yang patut dievaluasi.
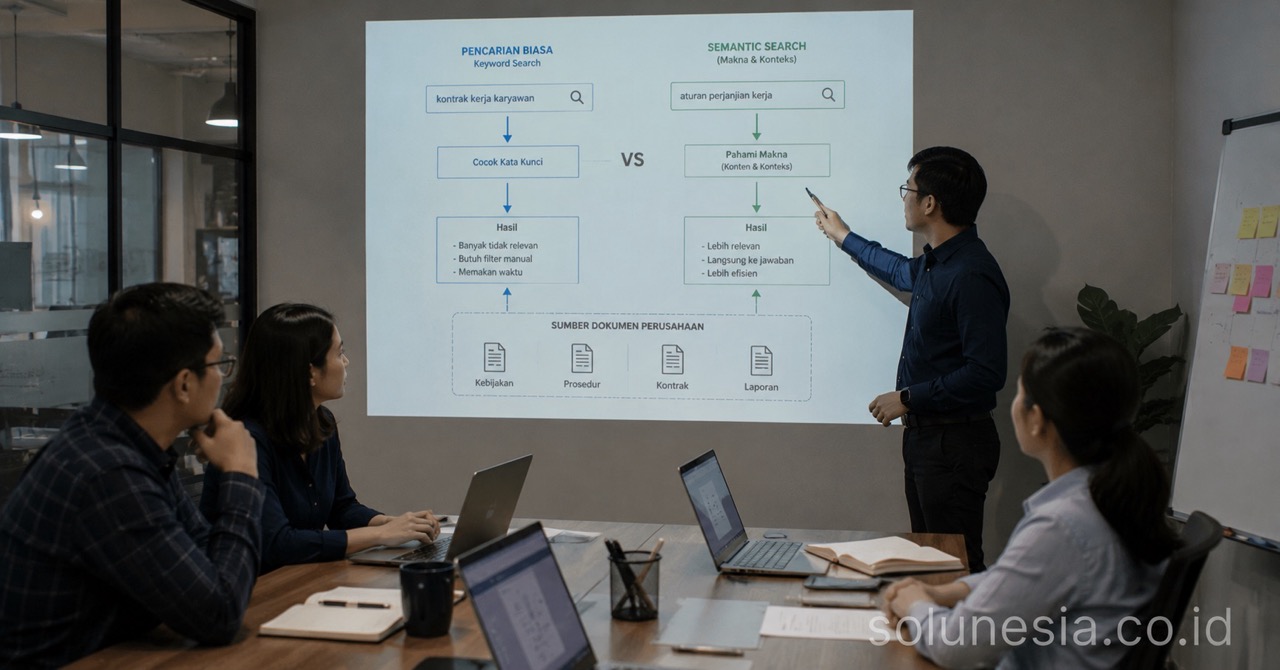
Pencarian semantik tidak mencari berdasarkan kata persis yang diketik. Sistem ini memahami maksud di balik kalimat tanya. Daripada mengandalkan operator boolean seperti AND atau OR, sistem menggunakan embedding vektor untuk merepresentasikan makna teks. Hasilnya, dokumen dengan kalimat “kebijakan cuti tahunan” bisa muncul meskipun pengguna mengetik “aturan liburan tahunan”. Lihat juga portfolio Solunesia.
Kapan Pencarian Biasa Mulai Bermasalah
Pencarian tradisional bekerja baik ketika pengguna tahu persis istilah yang dicari. Mencari nomor kontrak spesifik atau nama klien tertentu cukup mudah dengan sistem full-text search biasa.
Masalah muncul ketika kebutuhan informasi bersifat konseptual. Staf HRD mencari “prosedur saat karyawan sakit lama” tidak akan menemukan dokumen berjudul “Kebijakan Pengajuan Medical Check Up dan Cuti Sakit” jika tidak ada kata yang cocok. Sistem tradisional akan mencari kecocokan kata “sakit”, “karyawan”, dan “prosedur” secara terpisah, lalu mengurutkan hasil berdasarkan frekuensi kemunculan kata tersebut. Padahal jawaban sebenarnya mungkin ada di paragraf ketiga dokumen lain yang bahasanya berbeda.
Kondisi lain yang membuat pencarian biasa tidak memadai adalah dokumen lintas departemen. Tim legal mungkin menyebut “perjanjian kerja sama”, sementara tim operasional menyebutnya “kontrak vendor”. Manusia paham bahwa kedua istilah itu merujuk hal serupa, mesin pencari biasa tidak.
Mengapa Konteks Makna Lebih Penting daripada Kecocokan Kata
Sistem pencarian semantik memetakan teks ke dalam ruang vektor multidimensi. Kalimat yang maknanya mirip akan memiliki jarak vektor yang dekat, meskipun tidak ada satu kata pun yang sama. Konsep ini memungkinkan sistem menangkap intent pengguna.
Dalam implementasi praktis, pencarian semantik sering digabung dengan generasi teks atau jawaban. Sistem RAG mengambil dokumen paling relevan secara semantik, lalu LLM merangkum atau menjawab pertanyaan langsung dari dokumen tersebut. Jika Anda mengevaluasi solusi pencarian informasi cerdas, [[link:services/rag-knowledge-base|layanan RAG dan knowledge base]] dapat menjadi rujukan arsitektur yang matang.
Manfaat bisnisnya cukup jelas. Staf tidak perlu menghabiskan waktu menebak istilah yang “benar” untuk menemukan dokumen. Waktu pencarian berkurang drastis karena sistem mengembalikan hasil yang relevan sejak percobaan pertama. Selain itu, informasi yang sebelumnya “hilang” di kedalaman folder lambat laun bisa ditemukan dan dimanfaatkan kembali.
Karakteristik Dokumen Perusahaan yang Membutuhkan Semantic Search
Tidak semua basis data perusahaan memerlukan pencarian semantik. Sebuah aplikasi formulir kontak sederhana tidak membutuhkan vektor database. Namun ada beberapa kondisi di mana investasi pada teknologi ini memberikan dampak nyata.
- Volume Teks yang Besar dan Tidak Terstruktur. Ketika perusahaan memiliki ribuan dokumen dalam format PDF, Word, atau bahkan hasil scan yang sudah di-OCR, pencarian kata kunci memproduksi terlalu banyak hasil yang tidak relevan. Pengguna harus membuka dokumen satu per satu untuk memastikan apakah isinya benar-benar menjawab pertanyaan. Pencarian semantik memfilter hasil berdasarkan relevansi konteks, bukan kecocokan string. Volume data yang besar juga menyebabkan semantik pencarian lebih unggul dalam memilah informasi inti dari dokumen pendukung.
Sistem perpustakaan daerah Kepri yang dikelola Solunesia menyimpan lebih dari 27.000 judul. Untuk katalog ukuran itu, menavigasi berdasarkan kategori dan metadata boolean masih cukup memadai karena struktur datanya seragam. Namun bayangkan basis data yang menyimpan SOP, notula rapat, laporan keuangan, dan draft kontrak. Dokumen-dokumen ini tidak mengikuti satu format yang sama, itulah mengapa pencocokan makna jauh lebih membantu.
-
Pengetahuan Tersebar di Lintas Departemen. Dokumen perusahaan sering kali tersimpan di silo yang berbeda. Tim sales memiliki catatan klien, tim operasional punya logistik, dan tim keuangan punya invoice. Ketika seorang manajer mencari “klien yang sering telat bayar bulan lalu”, informasi yang dibutuhkan tersebar di setidaknya tiga departemen. Pencarian semantik bisa menjembatani gap terminologi antardepartemen asalkan semua dokumen tersebut terindeks di satu basis data vektor.
-
Bahasa Pengguna yang Sulit Diprediksi. Basis data internal sering ditulis dengan bahasa formal dan istilah teknis. Sayangnya, pengguna yang mencari informasi cenderung bertanya menggunakan bahasa sehari-hari. Seorang teknisi lapangan mungkin mencari “cara matiin alarm sensor gudang” sementara dokumen manualnya ditulis “Prosedur Menonaktifkan Notifikasi Sensor Ruang Penyimpanan”. Kemampuan untuk menjembatani perbedaan gaya bahasa ini adalah keunggulan utama dari pencarian berbasis vektor.
Risiko Implementasi dan Hal yang Perlu Dipertimbangkan
Membangun kemampuan pencarian semantik bukan sekadar memanggil API model embedding. Ada beberapa pertimbangan teknis yang sering luput saat tim IT merencanakan implementasi.
-
Kualitas data mentah. Sistem pencarian semantik mengekstraksi teks dari PDF atau gambar. Jika dokumen asli hasil scan kualitas rendah, teks hasil ekstraksi akan berantakan, vektor yang dihasilkan tidak merepresentasikan makna dengan akurat. Proses OCR dan pembersihan teks menjadi prasyarat wajib sebelum data masuk ke basis vektor. Sebagai gambaran, portofolio KSP Finance memanfaatkan OCR untuk dokumen ARC lintas negara, di mana akurasi pembacaan data fisik sangat menentukan validitas sistem keseluruhan.
-
Masalah chunking. Dokumen panjang tidak bisa diubah menjadi satu vektor. Teks harus dipotong menjadi potongan-potongan dengan tumpang tindih tertentu. Strategi pemotongan ini sangat memengaruhi akurasi pencarian. Memotong di tengah kalimat bisa merusak konteks. Menentukan ukuran chunk ideal memerlukan pengujian dan penyesuaian dengan karakteristik dokumen perusahaan.
-
Biaya infrastruktur. Basis data vektor membutuhkan sumber daya komputasi yang berbeda dari database relasional tradisional. Pengindeksan ulang saat dokumen diperbarui, pemeliharaan server, dan latensi pencarian harus dipantau. Solusi ini bukan sekadar plugin yang dipasang dan dilupakan.
-
Privasi dan kontrol akses. Memasukkan seluruh dokumen perusahaan ke dalam satu indeks semantik berisiko membuka akses informasi yang seharusnya terbatas. Sistem harus menghormati hak akses pengguna yang ada di portal internal. Anda tidak ingin staf biasa bisa mencari dan menemukan rahasia strategis perusahaan hanya karena dokumen itu tervisualisasi relevan dengan pertanyaannya.
Kesimpulan
Pencarian semantik bukan pengganti mutlak untuk pencarian biasa, melainkan komplemen. Sistem full-text search tetap efisien untuk pencarian terstruktur, nomor referensi, atau nama spesifik. Namun ketika basis data perusahaan didominasi teks naratif tidak terstruktur dan volume data bertumbuh, kemampuan memahami konteks makna menjadi kebutuhan operasional.
Mengembangkan arsitektur ini dari nol membutuhkan kehati-hatian tingkat tinggi, terutama dalam pengelolaan data dan integrasi kebijakan akses internal. Jika organisasi Anda sedang mempertimbangkan untuk mengadopsi kemampuan ini, diskusikan langsung dengan tim Solunesia melalui kontak kami agar kami bantu memetakan kebutuhan dan kelayakan teknisnya.
FAQ
Apakah pencarian semantik menggantikan Elasticsearch atau PostgreSQL Full-Text Search sepenuhnya?
Tidak. Keduanya bekerja berdampingan. Pencarian tradisional tetap unggul untuk pencarian berdasarkan ID, nama spesifik, atau kode unik. Pencarian semantik diolah secara terpisah untuk menangani pertanyaan berbasis narasi dan kebutuhan konseptual.
Apakah implementasi sistem semantik membutuhkan koneksi internet terus-menerus?
Tidak selalu. Model embedding dapat dijalankan secara on-premise menggunakan mesin server lokal. Namun, jika digabung dengan LLM untuk menghasilkan jawaban, Anda memerlukan GPU dengan kapasitas memori yang cukup besar agar proses inferensi tetap cepat.
Berapa lama waktu yang dibutuhkan untuk membangun sistem ini dari nol?
Waktu pengembangan bergantung pada kondisi dokumen dan kompleksitas akses internal. Jika dokumen sudah berupa teks digital yang rapi dan tidak ada kebijakan akses yang rumit, basis MVP bisa dibangun dalam hitungan minggu. Jika harus memproses ribuan file PDF hasil scan, persiapkan waktu untuk membersihkan data terlebih dahulu.
Apakah sistem ini bisa diintegrasikan dengan portal internal perusahaan yang sudah ada?
Bisa. Backend sistem pencarian semantik dapat diekspos melalui API. Aplikasi web atau portal internal yang sudah berjalan cukup memanggil endpoint API tersebut dan menampilkan hasilnya pada antarmuka pengguna yang sudah tersedia.
RelatedArticles
Further reading from other categories that may be relevant.
RAG Knowledge Base untuk Perusahaan: Kapan Arsitektur Event-Driven Dibutuhkan?
Fitur Penting Website Perusahaan Modern yang Perlu Diprioritaskan