Tantangan RAG untuk Dokumen Berbahasa Indonesia
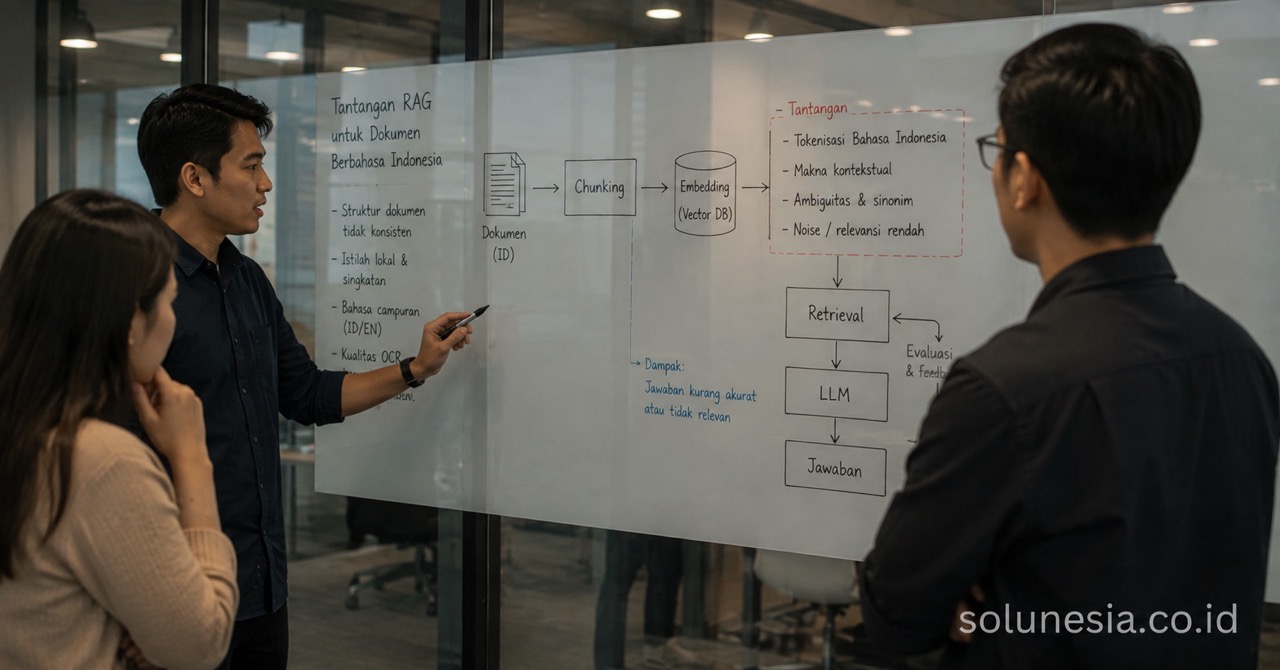
Menerapkan Retrieval-Augmented Generation (RAG) untuk dokumen berbahasa Indonesia membawa kompleksitas tersendiri. Banyak organisasi gagal saat mencoba membangun sistem tanya jawab internal karena model bahasa besar (LLM) sering kesulitan memahami struktur kalimat dan konteks lokal. Mengenal tantangan RAG dokumen Indonesia sejak awal membantu perusahaan menyiapkan strategi yang tepat sebelum membangun knowledge base AI.
Mengapa RAG untuk Bahasa Indonesia Berbeda
Mayoritas model bahasa besar dilatih dengan teks berbahasa Inggris. Meskipun beberapa model modern mendukung multi-bahasa, kualitas pemahaman mereka terhadap bahasa Indonesia tidak sebanding dengan bahasa Inggris. Masalah ini memuncak saat sistem harus memproses dokumen perusahaan yang mengandung campuran istilah formal, singkatan, dan dialek lokal.
Misalnya, sebuah perusahaan manufaktur di Batam mungkin memiliki dokumen SOP dengan campuran bahasa Indonesia, istilah teknis berbahasa Inggris, serta singkatan lokal. Sistem pencarian vektor standar sering gagal menangkap makna semantik yang tersembunyi di balik campuran kosakata tersebut. Akibatnya, jawaban AI terhadap pertanyaan pengguna terasa tidak relevan atau keliru menerjemahkan istilah teknis.
Proses tokenisasi menjadi sumber masalah utama. Model bahasa memecah teks menjadi token sebelum diubah menjadi vektor, tetapi algoritma bawaan sering memotong kata berimbuhan bahasa Indonesia dengan buruk. Pemisahan imbuhan seperti “mem-per-ja-jab-an” tidak mengikuti pola kata bahasa Inggris yang hanya dipisah berdasarkan spasi. Hal ini menghasilkan vektor semantik yang lemah, membuat sistem sulit mencocokkan pertanyaan dengan dokumen sumber yang tepat.
Berikut beberapa contoh tantangan tokenisasi yang umum terjadi pada dokumen bahasa Indonesia:
- Kata dengan imbuhan panjang seperti “pembiayaan” atau “antrian” sering terpecah tidak sempurna.
- Campuran bahasa Indonesia dan Inggris dalam satu kalimat, seperti “SOP ERP” atau “SPBE digital”.
- Istilah teknis yang unik, misalnya “KSP Finance” atau “OTA channel manager”.
- Singkatan lokal yang tidak ada dalam kamus standar model bahasa besar.
Tantangan Tokenisasi dan Embedding
Untuk membangun RAG yang andal, kualitas embedding menentukan hasil akhir. Embedding adalah proses mengubah teks menjadi representasi numerik. Saat teks bahasa Indonesia diproses menggunakan model embedding generik, representasi numerik yang dihasilkan kehilangan banyak nuansa makna.
Banyak pengembang mencoba mengatasi ini dengan model khusus multi-bahasa, tetapi itu pun tidak cukup. Kamus bahasa Indonesia terus berkembang, terutama dalam konteks bisnis dan teknologi. Istilah seperti “pembiayaan syariah” atau “antrian SPBE” memiliki konteks spesifik yang tidak bisa dipahami tanpa penyesuaian pada korpus data lokal.
Beberapa pendekatan teknis yang sering dievaluasi meliputi penggunaan model sentence-transformer yang sudah dilatih dengan korpus Asia Tenggara, atau melakukan fine-tuning pada dataset lokal. Pemilihan strategi embedding harus disesuaikan dengan jenis dokumen yang akan diproses. Dokumen legalitas butuh pendekatan berbeda dibandingkan manual operasional pabrik.
Berikut beberapa pilihan pendekatan embedding yang bisa dipertimbangkan:
- Model sentence-transformer dengan pre-training Asia Tenggara untuk menangkap nuansa lokal.
- Fine-tuning pada dataset dokumen perusahaan yang sudah ada.
- Penggabungan embedding bahasa Indonesia dengan teknik metadata tambahan.
- Penggunaan model yang dilatih khusus untuk dokumen regulasi atau kontrak bisnis.
Strategi Chunking Dokumen Lokal
RAG memecah dokumen panjang menjadi potongan kecil (chunk) sebelum disimpan di vektor database. Strategi chunking standar memotong teks berdasarkan jumlah karakter atau paragraf. Praktik ini berisiko memutus konteks penting pada dokumen bahasa Indonesia yang sering menggunakan kalimat panjang dengan banyak anak kalimat.
Dokumen regulasi dan kontrak bisnis di Indonesia sering memuat pasal yang panjang dan saling terkait. Pemotongan naif berdasarkan panjang teks akan memisahkan suatu ketentuan dari pengecualian yang ada di paragraf berikutnya. Misalnya, bagian yang menjelaskan kewajiban bisa terpisah dari bagian yang menjabarkan pengecualian kewajiban tersebut, sehingga AI hanya mengambil kesimpulan sebagian dan menyesatkan pengguna.
Pendekatan yang lebih sesuai menggunakan chunking berbasis struktur dokumen. Sistem perlu memahami hierarki: bab, bagian, pasal, dan ayat. Dengan mempertahankan batas struktur legal atau format manual, sistem memastikan konteks setiap potongan teks tetap utuh. Menambahkan metadata tambahan seperti nomor halaman dan judul bab juga membantu proses pencarian menjadi jauh lebih akurat.
Beberapa strategi chunking yang bisa dicoba:
- Chunking berdasarkan paragraf untuk dokumen narasi panjang.
- Chunking berbasis struktur dokumen seperti bab dan pasal.
- Chunking dengan ukuran tetap 500-1000 karakter untuk keseimbangan konteks.
- Chunking hibrida yang menggabungkan ukuran teks dan hierarki dokumen.
Menangani Data Tabel dan Format Tidak Terstruktur
Banyak dokumen perusahaan di Indonesia tidak berbentuk narasi murni. Laporan keuangan, daftar inventaris gudang, dan jadwal shift kerja sering menggunakan tabel kompleks. Proses ekstraksi teks dari format PDF atau gambar sering menghancurkan struktur tabel, mengubahnya menjadi deretan angka dan kata acak yang tidak bisa dipahami oleh model LLM.
Sebelum sistem RAG dapat menjawab pertanyaan, data dari tabel perlu dipulihkan strukturnya. Hal ini memerlukan integrasi sistem pengenalan dokumen cerdas sebelum proses embedding dilakukan. Dalam proyek sebelumnya seperti OCR dokumen ARC pada sistem fintech lintas negara KSP Finance, ekstraksi data terstruktur menjadi krusial agar dokumen keuangan bisa dibaca secara akurat. Proses serupa perlu diterapkan sebagai lapisan awal sebelum dokumen masuk ke dalam knowledge base.
Berikut langkah-langkah yang bisa dilakukan untuk mengatasi data tabel:
- Lakukan ekstraksi teks terlebih dahulu menggunakan OCR sebelum embedding.
- Pulihkan struktur tabel dengan metadata tambahan seperti judul kolom.
- Simpan referensi silang antara tabel dan teks narasi di dalam dokumen.
- Gunakan sistem computer vision untuk mendeteksi dan mengekstrak tabel secara otomatis.
Memilih Model LLM yang Sesuai
Setelah konteks dokumen berhasil diambil, LLM bertugas menyusun jawaban. Pemilihan model memengaruhi gaya bahasa dan akurasi jawaban. Model besar tertentu menghasilkan jawaban cenderung terjemahan Inggris yang kaku, sedangkan model lain lebih natural dalam meniru gaya bahasa formal Indonesia.
Sebagai pengembang software enterprise di Batam, pengalaman kami menunjukkan bahwa evaluasi model tidak bisa hanya mengandalkan laporan benchmark publik. Pengujian harus dilakukan pada dataset dokumen perusahaan yang nyata. Indikator penting bukan sekadar akurasi pemrosesan teks, melainkan konsistensi model dalam memberikan kutipan sumber dokumen dan menolak menjawab saat informasi tidak ada di database.
Untuk mengevaluasi pilihan solusi AI atau sistem tanya jawab internal perusahaan, halaman layanan RAG Systems & Knowledge Base AI memberikan gambaran arsitektur yang tepat untuk kebutuhan tersebut.
Mitigasi Halusinasi pada Konteks Spesifik
Halusinasi terjadi saat LLM merangkai jawaban yang tidak didukung oleh dokumen sumber. Dalam konteks dokumen perusahaan, hal ini berisiko tinggi karena keputusan bisnis yang dibuat dari informasi yang salah dapat menimbulkan kerugian finansial. Model berbahasa Inggris cenderung mengarang jika tidak menemukan jawaban yang cocok. Perilaku ini berbahaya untuk kebutuhan compliance atau dokumen hukum.
Penerapan sistem prompt yang memaksa model hanya menjawab berdasarkan konteks yang diambil adalah langkah pertama. Namun, prompt saja tidak cukup. Sistem perlu menambahkan lapisan validasi otomatis untuk membandingkan jawaban yang dihasilkan terhadap potongan teks asli yang dipakai sebagai konteks. Jika tingkat kemiripan semantik antara jawaban model dan teks sumber di bawah ambang batas tertentu, sistem sebaiknya menolak memberikan jawaban dan meminta klarifikasi dari pengguna.
Beberapa teknik mitigasi halusinasi yang bisa diterapkan:
- Tambahkan instruksi prompt untuk selalu menyertakan kutipan sumber dokumen.
- Terapkan validasi semantik antara jawaban dan potongan teks asli.
- Gunakan ambang batas kemiripan vektor untuk menolak jawaban tidak akurat.
- Integrasikan feedback dari pengguna untuk memperbaiki model secara bertahap.
Kesimpulan
Membangun sistem RAG untuk dokumen bahasa Indonesia bukan sekadar mengaktifkan API dan mengunggah file PDF. Dari pemilihan model hingga strategi pemecahan teks, setiap tahap menentukan keandalan jawaban yang diberikan. Organisasi yang memahami kendala teknis ini sejak awal dapat menyusun implementasi yang lebih terarah dan efisien.
Jika tim Anda sedang mengevaluasi penerapan knowledge base AI dan ingin mendiskusikan pendekatan yang sesuai untuk tipe dokumen perusahaan, tim kami terbuka untuk berdiskusi. Silakan hubungi Solunesia untuk eksplorasi lebih lanjut.
FAQ
Apakah model LLM gratis bisa menangani dokumen bahasa Indonesia?
Bisa, namun dengan keterbatasan. Model gratis umumnya memiliki akurasi lebih rendah pada bahasa Indonesia dan sering kehilangan konteks lokal. Untuk kebutuhan enterprise, pengujian menyeluruh dan penyesuaian pada korpus data diperlukan sebelum digunakan dalam skala produksi.
Apakah RAG bisa membaca dokumen PDF hasil scan?
Harus melalui proses OCR terlebih dahulu. OCR mengekstrak teks dari gambar, lalu teks tersebut diolah sistem RAG. Kualitas OCR sangat menentukan tingkat akurasi jawaban dari knowledge base yang dibangun.
Bagaimana mengatasi jawaban AI yang sering keliru di sistem RAG?
Periksa strategi chunking dan kualitas embedding. Pemotongan teks yang buruk serta representasi vektor yang lemah adalah penyebab utama jawaban tidak relevan. Evaluasi ulang ambang batas kemiripan vektor dan terapkan validasi jawaban otomatis.
Apakah perlu fine-tuning model untuk dokumen internal perusahaan?
Tidak selalu. Banyak kasus dapat diselesaikan dengan prompt engineering yang baik dan metadata yang terstruktur. Fine-tuning dipertimbangkan ketika dokumen memiliki jargon industri yang sangat spesifik dan model tidak mampu memahaminya secara bawaan.
Berapa lama proses pembangunan sistem RAG dasar?
Bervariasi tergantung volume dan kompleksitas format dokumen. Proses ini mencakup persiapan data, pembuatan pipeline ekstraksi, hingga pengujian model. Pengerjaan yang matang pada tahap awal akan mengurangi biaya perawatan sistem di masa depan.
RelatedArticles
Further reading from other categories that may be relevant.
RAG Knowledge Base untuk Perusahaan: Kapan Arsitektur Event-Driven Dibutuhkan?
Fitur Penting Website Perusahaan Modern yang Perlu Diprioritaskan