Hybrid Search vs Vector Search: Mana yang Lebih Cocok untuk RAG?
Hybrid Search vs Vector Search: Mana yang Lebih Cocok untuk RAG?
Membangun sistem RAG (Retrieval Augmented Generation) sering kali terhambat pada satu keputusan arsitektur: bagaimana cara mengambil dokumen yang paling relevan. Banyak tim IT langsung melompat ke vector search karena dianggap modern, tetapi dalam praktik nyata, pencarian berbasis embedding sering kehilangan konteks penting seperti nomor kontrak, kode SKU, atau nama spesifik. Pertanyaan tentang hybrid search vs vector search bukan sekadar masalah teknis, melainkan bagaimana sistem Anda menangkap maksud pengguna dan memberikan jawaban yang akurat.
Kekurangan Vector Search dalam Konteks Enterprise
Vector search mengubah teks menjadi representasi numerik (embedding) berdasarkan kedekatan makna. Saat pengguna bertanya “berapa total tagihan bulan lalu?”, sistem akan mencari dokumen yang maknanya mirip dengan kalimat tersebut. Pendekatan ini sangat baik untuk pertanyaan konseptual, di mana sinonim dan parafrase sering digunakan.
Namun, kelemahannya muncul saat sistem harus menangani exact match. Misalnya, pengguna mencari nomor kontrak spesifik “SC-2024-0891” atau nama produk yang sangat teknis. Vector search bisa gagal mengambil dokumen yang tepat karena model embedding cenderung memprioritaskan kemiripan semantik daripada kecocokan string. Dalam sistem enterprise, dokumen sering sarat dengan kode, angka, dan istilah spesifik yang tidak bisa diabaikan.
Selain itu, vector search murni sulit memberikan transparansi. Saat hasil yang muncul dirasa tidak relevan, developer kesulitan melakukan debugging karena jarak antar vektor tidak selalu mencerminkan alasan logis yang bisa diterima manusia. Hal ini menjadi masalah saat sistem RAG digunakan untuk kepatuhan (compliance) atau pengambilan keputusan finansial.
Mengapa Hybrid Search Menjadi Pilihan Tepat untuk Sistem RAG
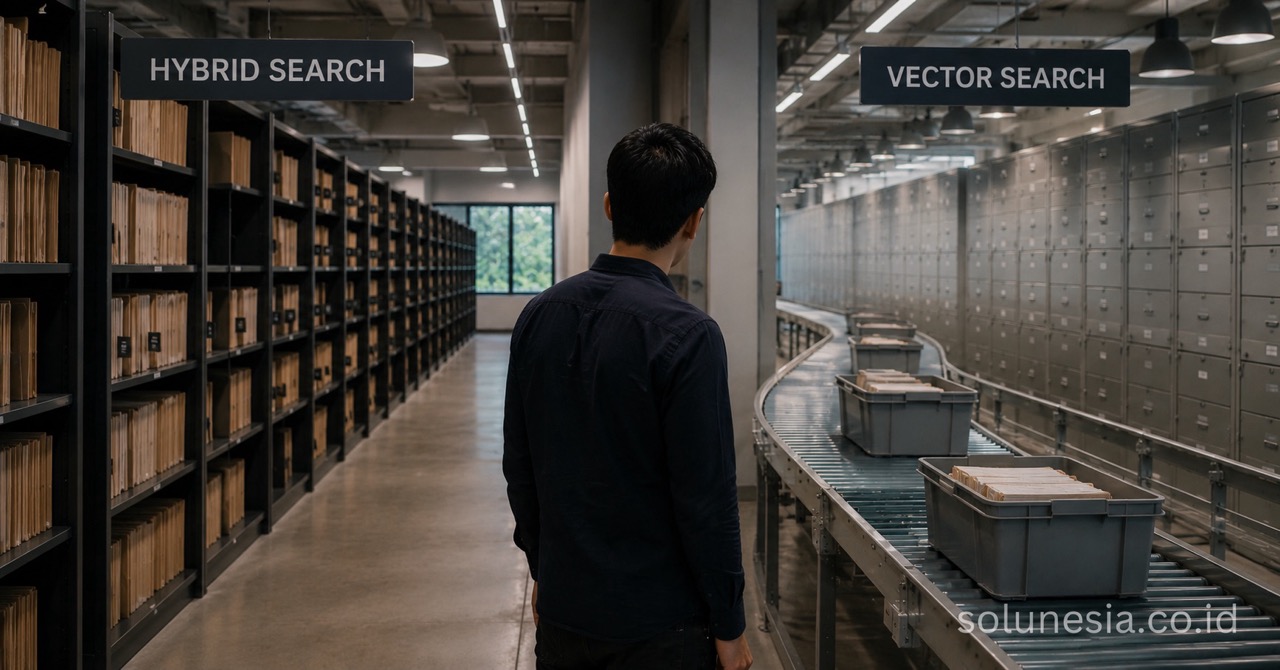
Hybrid search menggabungkan dua pendekatan: keyword search (sparse retrieval seperti BM25) dan vector search (dense retrieval). Alih-alih mengandalkan satu metode, sistem memberi skor pada kedua hasil lalu menggabungkannya. Pendekatan ini menjawab kelemahan mendasar dari kedua metode secara terpisah.
Dengan hybrid search, pertanyaan konseptual tetap ditangani oleh vector search, sementara kode dokumen, nama spesifik, atau istilah teknis ditangkap oleh keyword search. Misalnya, saat staf akuntansi mencari “KSP-045” dalam sistem knowledge base, keyword search memastikan dokumen yang mengandung teks persis tersebut muncul di urutan teratas, bukan dokumen lain yang secar semantik “mirip” namun salah.
Proses penggabungan skor biasanya menggunakan teknik seperti Reciprocal Rank Fusion (RRF). Teknik ini mengurutkan ulang hasil berdasarkan peringkat dari kedua metode, memberikan keseimbangan antara relevansi makna dan kepresisian kata. Hasilnya adalah sistem RAG yang lebih andal, terutama ketika menangani korpus dokumen perusahaan yang bervariasi mulai dari kontrak legal hingga manual teknis.
Kapan Cukup Pakai Vector Search Saja
Tidak semua sistem RAG membutuhkan kompleksitas hybrid search. Vector search murni sudah cukup jika:
- Korpus dokumen didominasi oleh teks naratif, artikel pengetahuan umum, atau FAQ yang sederhana.
- Sistem melayani pertanyaan pelanggan yang luas seperti “bagaimana cara reset password?” yang tidak bergantung pada exact match.
- Volume data kecil hingga menengah, sehingga tidak terlalu terdampak kekurangan vector search.
- Tim IT mengembangkan prototipe internal untuk divisi HR yang hanya berisi beberapa puluh dokumen.
Pertimbangan lain adalah biaya komputasi. Vector database seperti Pinecone atau Milvus cukup ringan untuk di-maintain dibandingkan cluster Elasticsearch yang harus menyimpan inverted index sekaligus vector index dalam skala besar. Untuk perusahaan yang baru menguji coba implementasi LLM, memulai dengan arsitektur yang lebih sederhana adalah langkah praktis.
Arsitektur Hybrid Search untuk Dokumen Skala Besar
Untuk perusahaan yang mengelola ribuan dokumen terstruktur seperti kontrak, laporan keuangan, atau manual SOP, hybrid search menjadi penting untuk dipertimbangkan. Arsitektur yang tepat akan memastikan retrieval tidak menjadi bottleneck dalam pipeline RAG.
Beberapa elemen kunci yang perlu diperhatikan meliputi:
- Metadata filtering yang ketat. Sebelum proses pencarian dilakukan, dokumen harus sudah ter-filter berdasarkan atribut seperti tahun, departemen, atau jenis dokumen. Metadata filtering mengurangi ruang pencarian secara drastis. Sebuah sistem RAG untuk manajemen dokumen perusahaan daerah bisa memanfaatkan filter ini untuk membatasi pencarian hanya pada regulasi yang dikeluarkan tahun tertentu, mencegah jawaban yang mengutip dokumen kedaluwarsa.
- Strategi chunking yang cerdas. Memotong dokumen secara terlalu agresif akan menghilangkan konteks. Memotong terlalu longgar akan mengencerkan relevansi. Sistem yang baik memahami struktur dokumen, memisahkan berdasarkan paragraf, judul, atau tabel, bukan sekadar memotong berdasarkan jumlah token secara kaku.
- Pengelolaan pipeline yang terintegrasi. Kombinasi antara sparse retrieval dan dense retrieval harus didukung dengan teknik penggabungan skor seperti Reciprocal Rank Fusion (RRF).
Implementasi nyata pada proyek perpustakaan daerah dengan puluhan ribu judul menunjukkan bahwa kemampuan pencarian harus mencakup berbagai format metadata. Dalam sistem katalog seperti OPAC, pengguna mungkin mencari berdasarkan judul, pengarang, atau ISBN. Pencarian semantik murni tidak cukup; sistem harus mampu mencocokkan teks spesifik pada metadata terstruktur. Menggabungkan pencarian berbasis keyword dan semantik memberikan hasil yang lebih memuaskan bagi pengguna akhir. Anda dapat melihat bagaimana pendekatan ini diterapkan pada layanan RAG Knowledge Base untuk mendapatkan gambaran arsitektur yang matang.
Evaluasi dan Tuning Sistem RAG
Membangun sistem RAG bukan proses sekali jalan. Setelah arsitektur hybrid search berjalan, tahap berikutnya adalah evaluasi. Tim IT perlu mendefinisikan dataset pertanyaan dan jawaban yang diharapkan untuk mengukur akurasi.
Beberapa langkah penting dalam evaluasi meliputi:
- Tuning bobot antara keyword dan vector search. Tuning bobot sangat bergantung pada karakteristik data. Jika dokumen perusahaan didominasi oleh kode dan angka, bobot keyword search perlu dinaikkan. Jika dokumen berupa panduan atau penjelasan naratif, bobot semantik bisa lebih dominan. Tidak ada angka baku untuk pembagian bobot ini; harus diuji secara iteratif terhadap kasus penggunaan nyata.
- Pengujian kasus negatif. Apa yang terjadi saat pertanyaan tidak memiliki jawaban di korpus? Sistem RAG yang buruk akan tetap memaksa jawaban berdasarkan dokumen yang kurang relevan. Sistem yang baik akan mendeteksi ambang batas relevansi dan memilih untuk mengembalikan respons “tidak ditemukan” daripada berhalusinasi. Hal ini krusial untuk sistem yang digunakan dalam pengambilan keputusan bisnis.
Evaluasi juga harus mencakup kasus negatif. Sistem yang baik akan mendeteksi ambang batas relevansi dan memilih untuk mengembalikan respons “tidak ditemukan” daripada berhalusinasi.
Kesimpulan
Pemilihan antara hybrid search dan vector search bergantung pada karakteristik data dan kebutuhan akurasi sistem Anda. Jika dokumen enterprise sarat dengan kode, nama spesifik, dan angka, hybrid search adalah pilihan yang lebih aman. Jika sistem melayani pertanyaan konseptual dengan teks naratif, vector search sederhana bisa memadai. Evaluasi kebutuhan retrieval Anda sebelum menambah kompleksitas yang tidak perlu pada arsitektur.
Jika tim Anda sedang merancang sistem RAG dan ingin mendiskusikan pendekatan retrieval yang paling sesuai dengan karakteristik dokumen perusahaan, hubungi tim Solunesia untuk berdiskusi lebih lanjut.
FAQ
Apakah hybrid search selalu lebih mahal secara komputasi?
Tidak selalu. Biaya bergantung pada volume data dan tools yang dipilih. Banyak vector database modern sudah mengintegrasikan kemampuan sparse retrieval, mengurangi kebutuhan menjalankan dua infrastruktur terpisah.
Bisakah sistem RAG beralih dari vector ke hybrid kapan saja?
Bisa, tetapi proses migrasi memerlukan penyesuaian indeks dan evaluasi ulang dataset. Jika volume dokumen sudah besar, persiapan arsitektur awal dengan hybrid search akan jauh lebih efisien daripada retrofit di kemudian hari.
Apa indikasi sistem RAG butuh beralih ke hybrid search?
Indikasi utamanya adalah ketika pengguna sering mengeluh jawaban AI tidak relevan padahal informasi ada di dokumen, terutama saat mereka mencari kode, nama orang, atau angka spesifik yang gagal ditangkap vector search.
Bagaimana cara menguji akurasi hybrid search sebelum produksi?
Siapkan set pertanyaan sampel beserta dokumen jawaban yang diharapkan. Lakukan A/B testing dengan membandingkan hasil rank fusion berbeda untuk melihat konfigurasi bobot mana yang memberikan recall paling tinggi.
RelatedArticles
Further reading from other categories that may be relevant.
RAG Knowledge Base untuk Perusahaan: Kapan Arsitektur Event-Driven Dibutuhkan?
Fitur Penting Website Perusahaan Modern yang Perlu Diprioritaskan