Evaluasi Sistem RAG: Apa yang Perlu Diukur Sebelum Dipakai Karyawan atau Pelanggan?
Evaluasi Sistem RAG: Apa yang Perlu Diukur Sebelum Dipakai Karyawan atau Pelanggan?
Membangun sistem Retrieval-Augmented Generation (RAG) untuk mencari informasi dari dokumen perusahaan kini relatif mudah. Tapi memastikan sistem itu benar-benar layak dipakai di lingkungan produksi adalah tantangan utama. Evaluasi rag system production sebelum dipakai karyawan atau pelanggan sangat penting agar jawaban yang diberikan tidak menyesatkan.
Sebagai CTO atau decision maker, tugas Anda adalah memastikan investasi AI ini berdampak positif dan tidak menimbulkan risiko operasional. Berikut adalah metrik dan pertimbangan krusial yang perlu dievaluasi sebelum sistem diluncurkan.
Mengapa RAG Bisa Gagal di Produksi
RAG menggabungkan pencarian dokumen (retrieval) dengan model bahasa (generation). Kedua tahap ini punya titik kegagalan masing-masing. Jika retrieval gagal menemukan dokumen yang tepat, model bahasa akan menjawab berdasarkan informasi yang salah atau halusinasi. Sebaliknya, jika retrieval menemukan dokumen yang tepat tapi model bahasa gagal merangkainya, jawaban akhirnya akan membingungkan.
Masalah lain muncul saat dokumen perusahaan terus bertambah. Sistem yang berjalan baik dengan 50 dokumen uji coba bisa melambat atau memberikan hasil tidak akurat saat sudah menampung ribuan file. Evaluasi di lingkungan pengembangan sering kali menggunakan pertanyaan ideal yang tersusun rapi. Di dunia nyata, karyawan atau pelanggan sering mengetik pertanyaan singkat, ambigu, atau menggunakan istilah internal yang tidak terduga.
Tanpa evaluasi yang terukur, sistem ini berisiko menjadi beban. Tim support tetap harus memeriksa jawaban AI secara manual. Karyawan kehilangan kepercayaan pada sistem dan kembali mencari informasi lewat cara lama. Pelanggan yang menerima jawaban salah bisa langsung mengeluh di media sosial.
Metrik Penting dalam Evaluasi RAG System Production
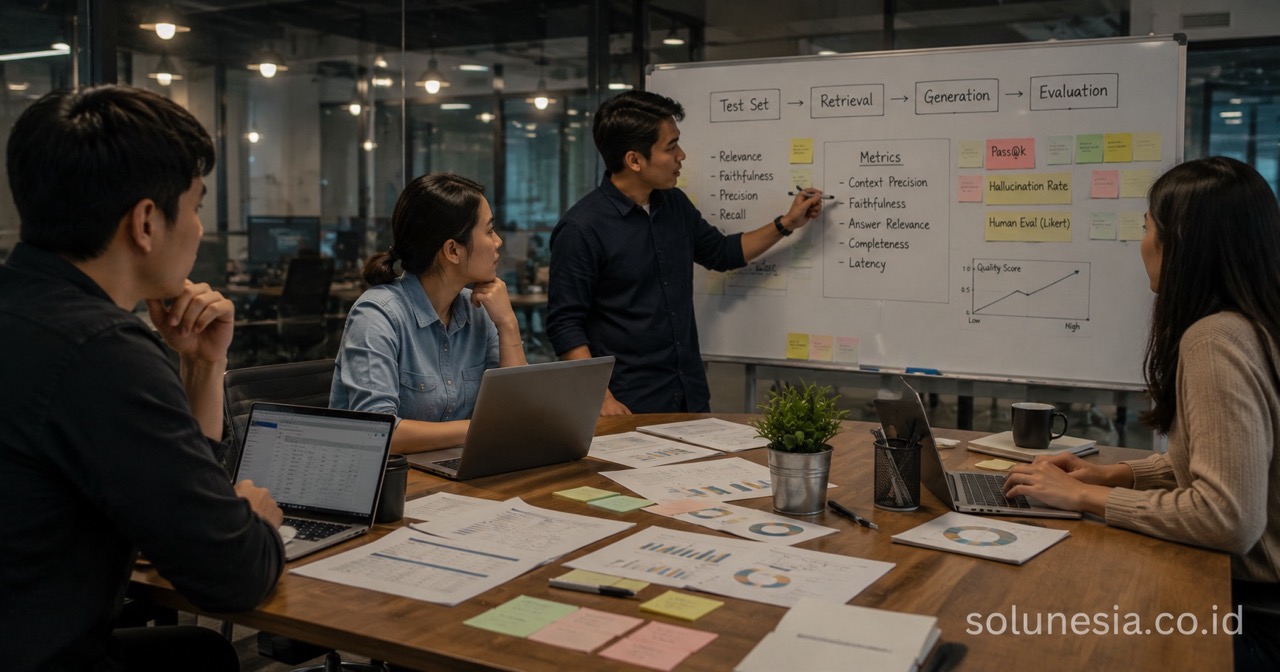
Evaluasi sistem RAG untuk produksi tidak bisa hanya mengandalkan intuisi bahwa “jawabannya terlihat benar”. Dibutuhkan pendekatan kuantitatif untuk mengukur kualitas sebenarnya. Berikut tiga metrik utama yang paling sering diukur:
- Kualitas Retrieval: Kemampuan sistem menemukan dokumen yang relevan. Metrik tradisional seperti Precision dan Recall menunjukkan seberapa banyak dokumen yang diambil benar-benar berkaitan dengan pertanyaan pengguna. Jika metrik ini rendah, masalah biasanya ada pada konfigurasi database vektor, pemilihan model embedding, atau cara dokumen dipecah (chunking) saat proses awal.
- Kualitas Generasi (Faithfulness): Setelah dokumen ditemukan, apakah model bahasa merangkai jawabannya berdasarkan teks tersebut? Metrik faithfulness memastikan AI tidak mengarang informasi di luar konteks yang diberikan. Hal ini sangat krusial untuk kepatuhan industri seperti keuangan atau layanan publik, di mana jawaban spekulatif bisa berujung pada masalah hukum.
- Relevansi Jawaban: Jawaban mungkin secara fakta merujuk pada dokumen, tetapi tidak menjawab pertanyaan spesifik dari pengguna. Mengukur relevansi memastikan AI memahami intent asli dari pertanyaan tersebut. Misalnya, jika karyawan bertanya “berapa batas minimum pengajuan pinjaman”, sistem tidak boleh menjelaskan seluruh prosedur pinjaman, melainkan langsung memberikan angka yang dimaksud.
Untuk mengotomatisasi pengukuran ketiga aspek ini, tim engineering biasanya memanfaatkan framework seperti RAGAS (RAG Assessment) yang membandingkan hasil sistem dengan dataset evaluasi yang sudah disiapkan.
Faktor Operasional di Luar Akurasi
Akurasi jawaban hanyalah satu sisi mata uang. Sistem yang berjalan di produksi harus menghadapi realitas operasional sehari-hari.
Latensi atau Waktu Respons
Karyawan menunggu jawaban internal bisa toleran selama beberapa detik. Pelanggan yang berinteraksi dengan chatbot mengharapkan respons cepat. Jika RAG memerlukan waktu 15 detik untuk memproses satu pertanyaan sederhana karena memproses terlalu banyak dokumen konteks, pengguna akan meninggalkannya. Anda perlu mengevaluasi trade-off antara kedalaman jawaban dan kecepatan respons.
Keamanan dan Kontrol Akses (RBAC)
Dokumen perusahaan memiliki tingkat kerahasiaan yang berbeda. RAG yang tidak menghormati kontrol akses bisa menjadi bencana keamanan. Jika karyawan dari divisi operasional bisa menanyakan dan mendapatkan jawaban dari dokumen keuangan internal perusahaan, berarti sistem gagal mengimplementasikan izin akses. Filter dokumen harus diterapkan sebelum hasil pencarian dikirim ke model bahasa. Untuk kebutuhan pencarian dokumen cerdas yang aman, Solunesia menyediakan layanan RAG knowledge base yang dirancang dengan pertimbangan keamanan enterprise.
Pemeliharaan Knowledge Base
Dokumen perusahaan terus diperbarui. Kebijakan lama diganti, prosedur baru diterbitkan. Sistem RAG harus memiliki mekanisme sinkronisasi yang dapat memvalidasi dokumen usang. Evaluasi perlu memastikan bahwa saat sebuah kebijakan dicabut, sistem tidak lagi menggunakannya sebagai dasar pengetahuan untuk menjawab pertanyaan.
Penyiapan Dataset Pengujian Skenario Nyata
Evaluasi formal dengan metrik hanya bermakna jika dataset ujinya merepresentasikan penggunaan di dunia nyata. Terlalu sering tim pengembang membuat pertanyaan uji yang terstruktur dengan bahasa baku. Di lapangan, pengguna mengetik dengan kata kunci singkat, ada salah ketik, atau menggunakan bahasa sehari-hari.
Dataset pengujian sebaiknya terdiri dari berbagai variasi pertanyaan: pertanyaan faktual langsung, pertanyaan analitik yang membutuhkan rangkuman beberapa dokumen, dan pertanyaan di luar topik (out-of-domain) untuk menguji apakah sistem bisa menolak menjawab dengan sopan alih-alih berhalusinasi.
Jika Anda mengembangkan sistem ini untuk pelanggan, kumpulkan riwayat chat pertanyaan nyata dari tim support sebagai dasar evaluasi. Untuk penggunaan internal, minta beberapa karyawan dari berbagai divisi mencoba sistem dan catat di mana sistem tersebut kebingungan. Mengintegrasikan sistem ini dengan alur kerja yang lebih luas melalui layanan AI agent automation dapat membantu menyaring dan mengelompokkan jenis kueri pengguna secara efisien sebelum diproses oleh RAG.
Kesimpulan
Meluncurkan sistem RAG tanpa evaluasi metrik yang menyeluruh berarti mengandalkan keberuntungan. Pastikan tim teknis Anda mengukur kualitas retrieval, faithfulness, dan relevansi jawaban secara kuantitatif. Jangan lupakan aspek operasional seperti latensi, kontrol akses dokumen, dan mekanisme pembaruan knowledge base. Evaluasi sistem RAG untuk lingkungan produksi memastikan AI memberikan dampak nyata pada efisiensi kerja. Jika organisasi Anda sedang mempersiapkan implementasi AI serupa, tim Solunesia siap berdiskusi mengenai arsitektur yang sesuai kebutuhan melalui halaman kontak kami.
FAQ
Apa metrik paling penting dalam evaluasi RAG?
Tidak ada satu metrik tunggal. Namun, faithfulness (kesesuaian jawaban dengan dokumen sumber) biasanya paling krusial. Jika sistem AI menjawab di luar konteks dokumen yang diberikan, hal ini langsung merusak kepercayaan pengguna dan berpotensi menimbulkan risiko bagi perusahaan.
Bagaimana cara menguji RAG untuk pertanyaan di luar topik?
Sertakan pertanyaan out-of-domain dalam dataset uji. Sistem harus didesain untuk mendeteksi pertanyaan yang tidak memiliki konteks dalam knowledge base dan memberikan respons penolakan yang sopan. Ini mencegah model bahansa berhalusinasi atau memaksakan jawaban yang tidak relevan.
Apakah RAG butuh kontrol akses (RBAC)?
Wajib diterapkan jika dokumen perusahaan memiliki tingkat kerahasiaan berbeda. Sistem pencarian vektor harus memfilter dokumen berdasarkan peran pengguna sebelum mengirim konteks ke model bahasa, sehingga informasi sensitif tidak bocor ke karyawan yang tidak berwenang.
Berapa lama proses evaluasi RAG hingga siap produksi?
Bervariasi tergantung kompleksitas dokumen dan variasi pertanyaan. Biasanya membutuhkan beberapa iterasi penyesuaian parameter chunking, pemilihan model embedding, dan prompt tuning hingga metrik akurasi dan latensi stabil sesuai target.
Apa risiko utama jika RAG dievaluasi hanya secara manual?
Risiko terbesarnya adalah bias. Evaluasi manual cenderung hanya menguji skenario ideal dan mudah melewatkan edge case. Metrik otomatis seperti RAGAS membantu mengukur performa sistem secara objektif dan konsisten pada ribuan kombinasi pertanyaan yang tidak mungkin dicek satu per satu secara manual.
RelatedArticles
Further reading from other categories that may be relevant.
RAG Knowledge Base untuk Perusahaan: Kapan Arsitektur Event-Driven Dibutuhkan?
Technical Debt: Dampaknya pada Biaya dan Kecepatan Pengembangan