Akurasi RAG: Faktor yang Menentukan Kualitas Jawaban Sistem
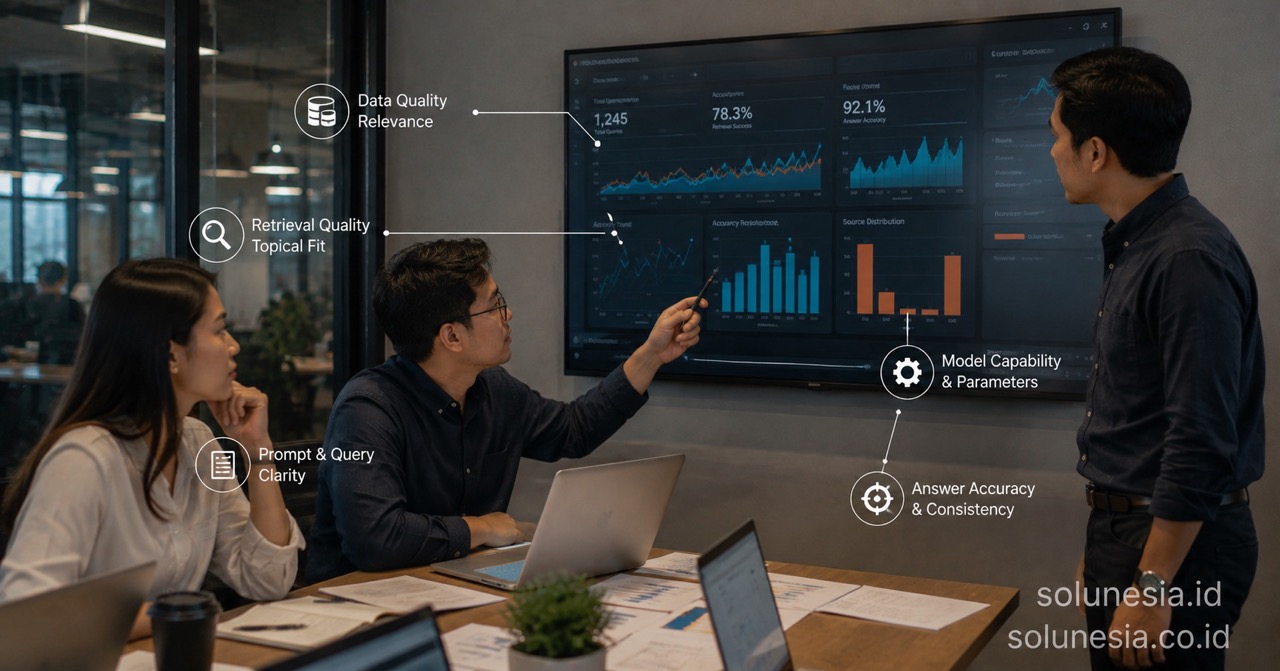
Akurasi RAG: Faktor yang Menentukan Kualitas Jawaban Sistem
Sistem Retrieval-Augmented Generation (RAG) sering dianggap sebagai cara langsung untuk menghubungkan dokumen perusahaan dengan jawaban otomatis. Namun, hasil yang akurat tidak datang dari sekadar memasukkan file ke database vektor dan memanggil model bahasa. Kualitas jawaban bergantung pada bagaimana seluruh pipeline pencarian dan generasi dirancang agar sesuai dengan kebutuhan organisasi.
Kenapa Banyak Implementasi RAG Gagal Memberikan Jawaban Akurat Lihat juga portfolio Solunesia. Pelajari juga blog Solunesia.
Banyak proyek RAG yang dijalankan di perusahaan berakhir dengan jawaban yang tidak memuaskan. Masalah utamanya bukan pada kekuatan model bahasa, melainkan pada tahap pengambilan informasi (retrieval). Dokumen perusahaan biasanya memiliki struktur yang rumit, mulai dari tabel yang saling terkait hingga referensi antar bagian yang saling menjelaskan.
Jika pemotongan teks (chunking) dilakukan secara kaku, misalnya hanya berdasarkan jumlah karakter tetap, maka kalimat penting bisa terpecah. Akibatnya, konteks yang dikirim ke model bahasa menjadi tidak lengkap. Hasilnya adalah jawaban yang keliru meski terdengar meyakinkan.
Masalah lain muncul dari penggunaan istilah yang ambigu. Dokumen internal sering menggunakan singkatan yang berbeda maknanya tergantung divisi. Tanpa mekanisme yang memahami konteks pengguna, sistem bisa mengambil dokumen yang tidak relevan. Akibatnya, model bahasa mengeluarkan jawaban yang salah secara faktual. Hal ini sangat berisiko ketika sistem digunakan untuk keputusan yang melibatkan data keuangan atau persyaratan kepatuhan.
Best Practices RAG Akurat untuk Mencapai Kualitas Jawaban yang Konsisten
Mencapai sistem RAG yang andal memerlukan perhatian pada beberapa aspek utama. Berikut adalah best practices rag akurat yang sering menjadi pembeda antara hasil biasa dan hasil yang benar-benar berguna bagi tim pengambilan keputusan.
-
Strategi Chunking dan Parsing Dokumen
Cara dokumen dipotong memengaruhi kemampuan sistem dalam mengambil informasi yang tepat. Memotong teks hanya berdasarkan jumlah karakter tetap sering merusak alur makna. Pendekatan yang lebih cocok adalah mempertahankan struktur semantik asli dokumen, seperti memisahkan berdasarkan judul section atau topik utama. Dokumen yang mengandung tabel besar memerlukan parser khusus agar data header dan isi tidak tercampur. -
Pemilihan Model Embedding
Embedding berfungsi sebagai representasi numerik dari teks agar sistem dapat melakukan pencarian semantik. Memilih model yang terlatih pada korpus bahasa campuran Indonesia dan Inggris sangat penting untuk dokumen perusahaan lokal. Model yang hanya dilatih pada bahasa Inggris saja sering kehilangan nuansa istilah yang khas di lingkungan Indonesia, sehingga pencarian tidak mengambil dokumen yang seharusnya relevan. -
Reranking untuk Presisi Pencarian
Pencarian vektor dasar sering mengembalikan puluhan dokumen dengan skor kemiripan tinggi. Namun, tidak semua dokumen tersebut benar-benar sesuai dengan pertanyaan pengguna. Proses reranking memeriksa ulang dokumen-dokumen teratas dan menyusun ulang berdasarkan kedekatan makna yang lebih tepat dengan pertanyaan spesifik. Langkah ini membantu meningkatkan kualitas jawaban secara keseluruhan. -
Desain Prompt dan Grounding LLM
Model bahasa perlu dibekali dengan batasan yang jelas agar tidak mengarang informasi. Prompt harus menginstruksikan model untuk hanya menjawab berdasarkan konteks yang diberikan. Jika informasi tidak tersedia dalam dokumen, sistem harus berani menyatakan bahwa data tersebut tidak ditemukan. Tanpa batasan ini, model berisiko menghasilkan jawaban yang salah dari pengetahuannya sendiri.
Menyesuaikan Sistem dengan Tipe Data Organisasi
Setiap organisasi memiliki karakteristik data yang berbeda, sehingga pendekatan RAG perlu disesuaikan. Pendekatan yang dibutuhkan perusahaan manufaktur di Batam akan berbeda dengan kebutuhan portal e-government di Tanjungpinang. Volume dokumen, format file, dan jenis informasi yang paling sering dicari menentukan arsitektur yang tepat.
Untuk dokumen regulasi pemerintah, pencarian teks penuh (keyword search) sering kali lebih diandalkan karena istilah hukum memiliki makna yang sangat spesifik dan tidak boleh diganti dengan sinonim. Pendekatan hybrid search yang menggabungkan pencarian teks penuh dengan pencarian semantik sering menjadi pilihan yang tepat. Sistem perpustakaan digital DPK Kepri yang mengelola ribuan judul menunjukkan bagaimana pencarian harus dirancang khusus untuk menangani metadata dan dokumen yang berat dalam skala besar.
Di sisi lain, platform e-commerce seperti Amazing Bintan yang mengelola ratusan destinasi wisata membutuhkan fleksibilitas pencarian semantik. Pengguna mungkin mencari informasi dengan cara yang tidak terduga, seperti “tempat snorkeling yang ramah anak”. Sistem harus mampu menghubungkan deskripsi tersebut ke paket wisata yang relevan. Pemahaman niat pengguna menjadi faktor penting agar jawaban yang diberikan benar-benar membantu.
Risiko Keamanan dan Privasi Data pada RAG
Memberikan akses model ke seluruh dokumen internal perusahaan membawa risiko yang sering terlupakan. Pertama, masalah hak akses pengguna. Staf yang bertanya tentang dokumen operasional seharusnya tidak menerima jawaban dari laporan yang bersifat sensitif. Sistem harus menerapkan filtering akses pada tahap retrieval, bukan hanya pada antarmuka aplikasi. Jika kontrol ini tidak ada, risiko membocorkan data rahasia ke pihak yang tidak berwenang menjadi nyata.
Kedua, kebocoran data melalui prompt. Karena data dikirim ke model, ada kemungkinan informasi sensitif ikut terbawa. Untuk mengatasi hal ini, pertimbangkan penggunaan model yang dideploy secara lokal atau di lingkungan cloud privat. Pengalaman Solunesia dalam membangun sistem OCR dan fintech lintas negara untuk KSP Finance menunjukkan pentingnya menangani dokumen sensitif dengan memperhatikan kepatuhan data dan keamanan informasi sebagai prioritas utama.
Mengukur Keberhasilan dan Evaluasi Sistem
Sistem RAG yang baik tidak berhenti setelah diluncurkan. Pengukuran akurasi perlu dilakukan secara berkala agar sistem tetap relevan dengan kebutuhan bisnis. Evaluasi dilakukan dengan menyediakan set pertanyaan sampel beserta jawaban yang benar. Sistem diuji untuk mengukur apakah proses retrieval berhasil mengambil dokumen sumber yang tepat dan apakah model bahasa menghasilkan jawaban yang sesuai dengan dokumen tersebut.
Metrik ini memberikan gambaran yang jelas. Daripada mengandalkan asumsi bahwa sistem berjalan baik, pengukuran berbasis data membantu tim IT mengetahui bagian mana yang perlu diperbaiki. Apakah chunking yang terlalu kecil, model embedding yang kurang sesuai, atau prompt yang kurang ketat. Tim IT bisa memantau penurunan performa saat dokumen baru ditambahkan dan melakukan penyesuaian segera.
Kesimpulan: Membangun RAG yang Dapat Diandalkan
Membangun sistem RAG yang akurat bukan sekadar menggabungkan teknologi, melainkan mengintegrasikan strategi pemrosesan dokumen, mekanisme pencarian yang presisi, dan batasan keamanan yang ketat. Tanpa perhatian pada detail ini, jawaban yang dihasilkan berisiko menyesatkan keputusan bisnis. Untuk mendiskusikan bagaimana arsitektur ini dapat diterapkan pada basis data perusahaan, silakan hubungi tim Solunesia di https://solunesia.co.id/contact/. Untuk mendiskusikan kebutuhan serupa di organisasi Anda, hubungi tim Solunesia atau pelajari layanan pengembangan software kami.
FAQ
Apa itu sistem RAG?
RAG adalah arsitektur AI yang menggabungkan pencarian dokumen dari basis data internal dengan model bahasa. Sistem ini memastikan jawaban yang diberikan AI merujuk pada data aktual perusahaan, bukan sekadar ingatan dari data latih model.
Kenapa sistem RAG sering memberikan jawaban keliru?
Jawaban keliru umumnya disebabkan oleh kegagalan proses retrieval. Sistem tidak berhasil mengambil dokumen yang tepat karena strategi pemotongan teks buruk, model embedding tidak cocok, atau pertanyaan pengguna ambigu sehingga konteks yang dikirim ke model bahasa kurang relevan.
Apakah RAG aman untuk dokumen rahasia perusahaan?
Cukup aman bila diimplementasikan dengan kontrol akses berlapis. Sistem harus menyaring dokumen berdasarkan otoritas pengguna pada tahap pencarian dan memilih opsi model yang dideploy secara privat untuk mencegah kebocoran data melalui layanan eksternal.
Bagaimana cara mengukur keberhasilan sistem RAG?
Keberhasilan diukur melalui metrik seperti context recall dan faithfulness. Sistem diuji dengan set pertanyaan sampel untuk melihat apakah retrieval mengambil dokumen yang tepat dan apakah jawaban yang dihasilkan sesuai dengan dokumen tersebut. Hasil evaluasi ini membantu tim IT mengetahui area yang perlu ditingkatkan.
RelatedArticles
Further reading from other categories that may be relevant.
RAG Knowledge Base untuk Perusahaan: Kapan Arsitektur Event-Driven Dibutuhkan?
Fitur Penting Website Perusahaan Modern yang Perlu Diprioritaskan