OCR Dokumen Indonesia: Faktor yang Menentukan Akurasi Sistem
OCR Dokumen Indonesia: Faktor yang Menentukan Akurasi Sistem
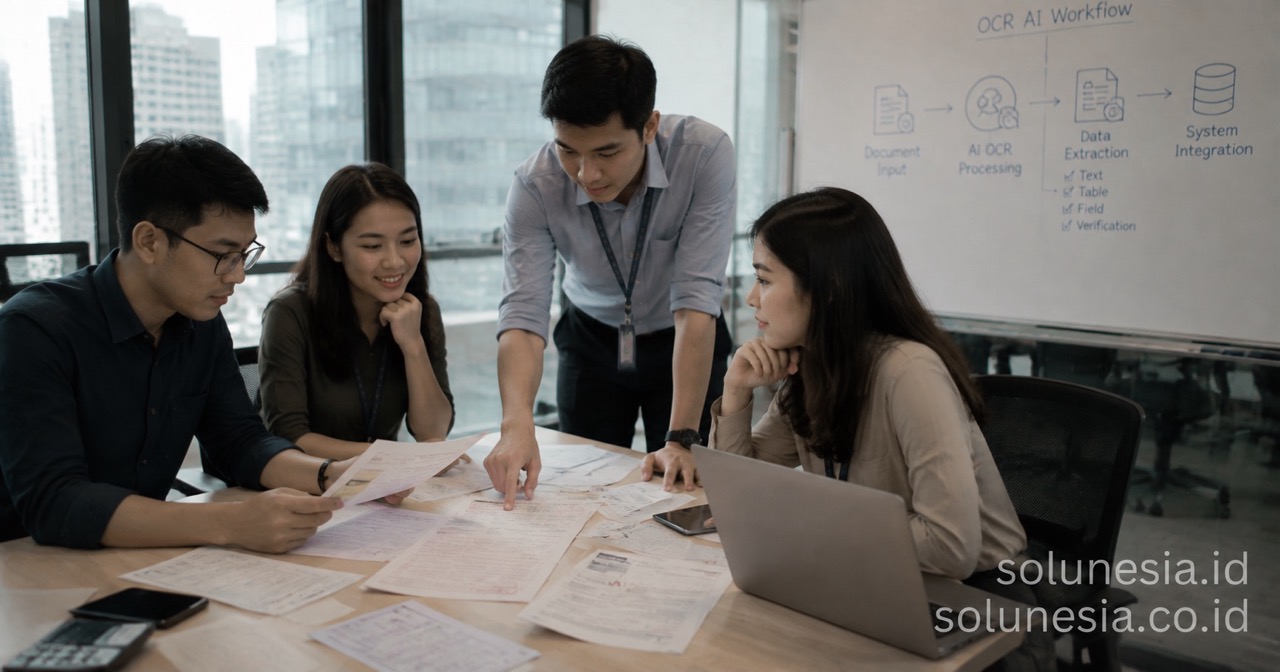
Di dunia bisnis yang semakin digital, dokumen tetap menjadi sumber data utama yang tak tergantikan. OCR (Optical Character Recognition) memungkinkan ekstraksi informasi akurat dari invoice, KTP, formulir, dan dokumen fisik lainnya tanpa memerlukan input manual yang memakan waktu. Model OCR dokumen Indonesia semakin penting karena beragamnya jenis dokumen resmi dan non-resmi, serta regulasi digitalisasi yang terus berkembang.
Artikel ini membahas faktor-faktor utama yang menentukan keakuratan sistem OCR, sehingga IT manager dan decision maker bisa mengevaluasi pilihan vendor dengan tepat. Keakuratan bukan sekadar soal teknologi, melainkan kombinasi antara kualitas input, pemahaman bahasa lokal, dan integrasi dengan proses bisnis yang ada. Lihat juga portfolio Solunesia.
Apa Itu Model OCR Dokumen Indonesia dan Mengapa Akurasinya Penting
Model OCR dokumen Indonesia bekerja dengan mengubah gambar dokumen menjadi teks yang bisa dibaca mesin. Teknologi ini berbeda dari OCR umum karena harus menangani karakteristik khas dokumen lokal, seperti variasi font Indonesia, tanda baca yang tidak standar, dan dokumen dalam bahasa daerah yang tersebar.
Keakuratan sistem ini menentukan keandalan seluruh proses bisnis. Kesalahan ekstraksi data bisa menyebabkan kesalahan perhitungan, keterlambatan verifikasi, hingga pelanggaran regulasi. Di sektor fintech, pemerintahan, atau manufaktur, kesalahan kecil dari OCR bisa berakumulasi menjadi masalah besar jika tidak ditangani sejak awal.
Faktor Utama yang Menentukan Akurasi Model OCR Dokumen Indonesia
Akurasi sistem OCR bergantung pada beberapa elemen kunci yang saling terkait:
- Kualitas gambar dokumen: Gambar yang buram, pudar, atau terlalu gelap sulit diubah menjadi teks yang bersih. Resolusi minimum yang direkomendasikan biasanya 300 DPI dengan pencahayaan yang merata.
- Kompleksitas bahasa dan font: Dokumen lokal sering menggunakan font standar seperti Arial atau Times New Roman, tetapi juga variasi khas yang muncul di formulir pemerintah atau invoice supplier. Model OCR yang tidak dilatih dengan data bahasa Indonesia akan kesulitan membedakan karakter serupa, seperti “o” dan “0”, atau “s” dan “5”.
- Jenis dan kondisi dokumen: Invoice dengan banyak tabel atau lampiran sulit diproses dibandingkan KTP yang lebih sederhana. Dokumen usang, lipatan, atau dengan tanda tangan tangan yang tidak jelas juga menurunkan performa.
- Data training model: Model yang dilatih dengan dataset lokal yang cukup besar akan jauh lebih baik dibandingkan model generik.
- Integrasi sistem backend: OCR yang berdiri sendiri tanpa koneksi dengan software enterprise akan kurang berguna. Data yang diekstrak harus bisa dimasukkan ke dalam database atau ERP tanpa perlu edit manual berulang.
Faktor-faktor ini saling memengaruhi. Misalnya, meski gambar dokumen bagus, tanpa data training yang tepat untuk bahasa Indonesia, akurasi tetap rendah.
Tantangan Khusus Dokumen Indonesia yang Sering Terabaikan
Dokumen Indonesia memiliki karakteristik unik yang membuat sistem OCR umum kesulitan. Salah satunya adalah penggunaan bahasa Indonesia yang sangat beragam, termasuk variasi ejaan di daerah-daerah terpencil dan penggunaan istilah teknis yang tidak konsisten. Selain itu, banyak dokumen masih dalam format fisik yang dipindai, sehingga ada risiko degradasi kualitas seiring waktu.
Regulasi juga memainkan peran penting. Dokumen seperti KTP, NPWP, atau surat pernyataan memerlukan ekstraksi data yang tepat untuk verifikasi kepatuhan. Kesalahan pada data sensitif ini bisa berdampak hukum dan keuangan. Di sektor fintech seperti KSP Finance, dokumen ARC (Atestasi Kesehatan) sering menjadi tantangan karena bentuk dan bahasa yang khas.
Selain itu, integrasi dengan sistem multi-kampus atau multi-cabang sering menimbulkan masalah. Dokumen yang dikirim dari berbagai lokasi memiliki variasi format dan pencahayaan yang berbeda. Tanpa preprocessing yang tepat, sistem OCR bisa gagal secara sistematis pada dokumen tertentu.
Strategi Membangun atau Memilih Model OCR yang Akurat
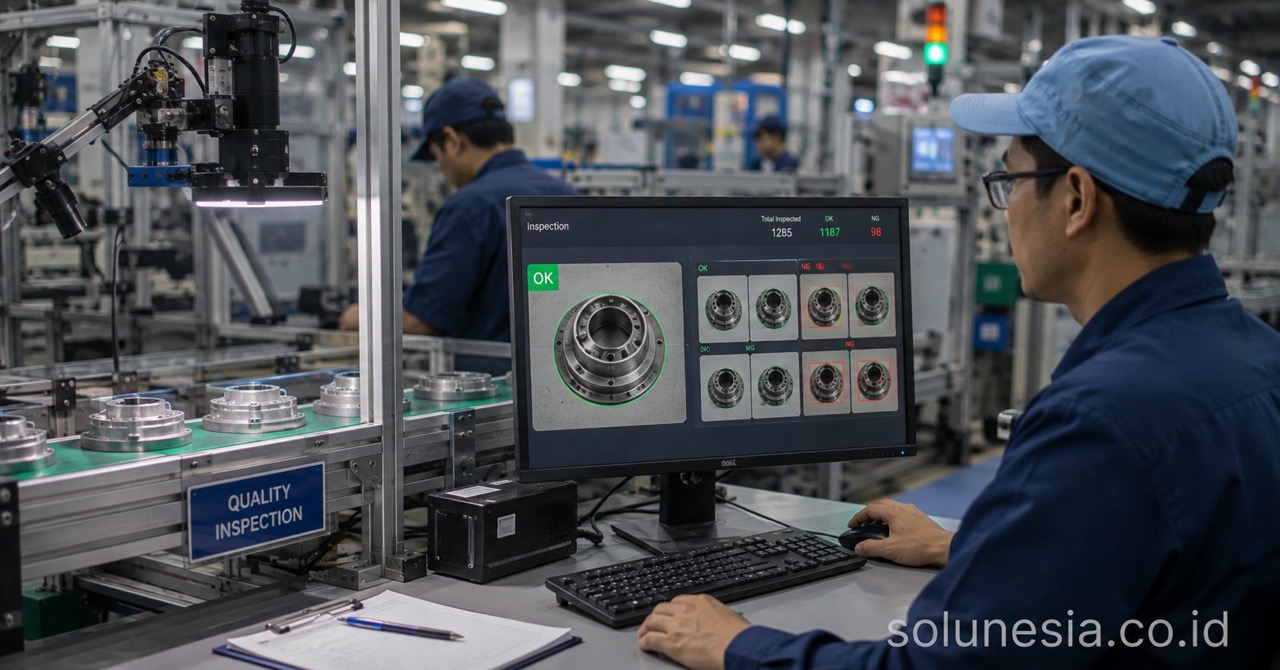
Pemilihan model OCR yang tepat dimulai dari pemahaman kebutuhan bisnis. Bagi perusahaan yang membutuhkan volume tinggi dan standar tinggi, membangun model custom dengan data lokal lebih menguntungkan daripada mengandalkan vendor asing yang tidak terlatih pada bahasa Indonesia. Solusi computer vision bisa membantu dengan melakukan preprocessing gambar secara otomatis, seperti deteksi sudut dokumen dan perbaikan pencahayaan.
Strategi lain adalah pendekatan hibrida. Gunakan model dasar untuk ekstraksi teks dasar, lalu tambahkan lapisan AI untuk koreksi kesalahan. Pendekatan ini terbukti efektif di banyak organisasi yang mengelola dokumen berbasis aturan.
Penting juga untuk mempertimbangkan skalabilitas. Model yang dirancang untuk invoice biasa mungkin tidak cocok untuk dokumen perpustakaan atau hotel dengan banyak variasi format. Evaluasi harus mencakup testing pada dataset perusahaan sendiri untuk mendapatkan hasil yang akurat.
Manfaat Menggunakan Model OCR Dokumen Indonesia yang Akurat
Sistem OCR yang akurat membawa manfaat langsung bagi operasional bisnis:
- Penghematan waktu signifikan: Proses ekstraksi data bisa dilakukan dalam hitungan detik.
- Pengurangan kesalahan manusia: Mengeliminasi kesalahan yang sering terjadi pada entri data manual.
- Pemrosesan real-time: Kemampuan untuk memproses dokumen secara langsung, yang sangat berguna di sektor logistik atau perbankan.
- Kepatuhan regulasi: Perusahaan yang bisa menunjukkan proses verifikasi dokumen yang terdokumentasi akan lebih mudah diaudit.
- Integrasi yang mulus: Data yang diekstrak bisa langsung masuk ke ERP, mengurangi duplikasi dan kesalahan entry.
Di portfolio Solunesia, sistem OCR yang diterapkan pada platform pinjaman lintas negara seperti KSP Finance telah membantu mengurangi onboarding manual dan mempercepat proses verifikasi.
Kesimpulan
Faktor yang menentukan akurasi sistem OCR dokumen Indonesia bukan hanya soal teknologi, melainkan kombinasi antara kualitas input, pemahaman bahasa lokal, kondisi dokumen, dan integrasi yang tepat. Memahami elemen-elemen ini membantu decision maker memilih solusi yang sesuai dengan kebutuhan organisasi, baik melalui pembelian model siap pakai maupun pengembangan custom.
Untuk mendiskusikan kebutuhan OCR dokumen Anda, tim Solunesia siap membantu. Kunjungi solunesia.co.id/contact untuk konsultasi awal.
FAQ
Apa faktor utama yang menentukan akurasi model OCR dokumen Indonesia?
Kualitas gambar dokumen, kompleksitas bahasa dan font, jenis dokumen, kualitas data training, serta integrasi sistem backend. Faktor-faktor ini saling memengaruhi dan menentukan seberapa baik sistem mampu mengekstrak teks dengan benar.
Bagaimana cara meningkatkan akurasi OCR untuk dokumen lokal?
Gunakan dataset pelatihan yang mencakup dokumen Indonesia asli, lakukan preprocessing gambar, dan lakukan testing rutin pada dataset perusahaan. Pendekatan ini membantu mengurangi kesalahan pada karakter yang serupa atau format dokumen yang kompleks.
Apakah Solunesia menyediakan layanan OCR dokumen?
Ya, melalui layanan computer vision yang mencakup ekstraksi data otomatis dari invoice, KTP, dan dokumen lainnya. Solusi ini dirancang untuk mengurangi input manual dan meningkatkan efisiensi proses verifikasi.
Apa perbedaan OCR dengan computer vision?
OCR fokus pada pengenalan karakter optik untuk mengubah gambar menjadi teks. Computer vision lebih luas dan mencakup preprocessing, deteksi objek, serta integrasi dengan sistem lain. Kombinasi keduanya sering digunakan untuk hasil yang lebih baik.
Bagaimana model OCR bisa diintegrasikan ke sistem enterprise?
Melalui API yang terhubung langsung dengan software yang ada, seperti ERP atau portal internal. Solusi ini memungkinkan ekstraksi data real-time dan penyimpanan otomatis ke database tanpa perlu edit manual berulang.
RelatedArticles
Further reading from other categories that may be relevant.
OCR untuk Data Entry: Kapan Bisa Menghemat Waktu dan Biaya?
Pelajaran dari Implementasi KYC Berbasis AI pada Fintech Multinasional