Halusinasi AI: Risiko, Penyebab, dan Cara Menguranginya
Halusinasi AI: Risiko, Penyebab, dan Cara Menguranginya
Model bahasa besar (LLM) kini menjadi tulang punggung banyak sistem otomasi di perusahaan. Namun ada satu masalah teknis yang sering muncul dan bisa merusak kepercayaan pengguna: AI menghasilkan jawaban yang terdengar meyakinkan tetapi faktanya salah. Dalam dunia engineering, fenomena ini dikenal sebagai halusinasi AI. Bagi decision maker, memahami risiko ini penting agar implementasi AI di sistem enterprise tidak berujung pada kerugian operasional. Proses mitigasi halusinasi bukan sekadar memilih model yang tepat, melainkan membangun arsitektur sistem yang membatasi ruang gerak AI agar tetap berakar pada data nyata.
Mengapa Model AI Menghasilkan Halusinasi? Lihat juga portfolio Solunesia.
Model bahasa bekerja dengan cara memprediksi kata berikutnya berdasarkan pola statistik dari data pelatihan. Mereka tidak memahami konsep benar atau salah seperti manusia. Ketika dihadapkan pada pertanyaan di luar data pelatihan atau konteks yang ambigu, model akan tetap mencoba merangkai jawaban yang paling mungkin secara statistik, meskipun tidak ada landasan faktual.
Penyebab utamanya bisa dilacak dari beberapa kondisi teknis. Pertama, data pelatihan yang mengandung informasi keliru, bias, atau opini yang ditulis dengan gaya faktual. Kedua, ketiadaan akses ke sumber data real-time. Model yang dilatih tahun lalu tidak akan tahu kebijakan perusahaan yang baru diperbarui minggu lalu, kecuali diberikan konteks tambahan. Ketiga, prompt yang terlalu umum. Saat instruksi pengguna tidak membatasi ruang jawaban, model cenderung mengarang detail untuk mengisi kekosongan informasi tersebut.
Dampak Risiko Halusinasi pada Operasional Enterprise
Risiko halusinasi sangat bergantung pada konteks penggunaan AI di perusahaan. Jika AI berfungsi untuk menyunting kalimat marketing atau merangkum teks internal, halusinasi mungkin hanya masalah estetika atau efisiensi minor. Namun risikonya berbeda ketika AI digunakan untuk mengambil keputusan finansial, hukum, atau layanan pelanggan.
Bayangkan sistem chatbot layanan pelanggan yang mengarang suku bunga atau ketentuan pinjaman yang tidak ada di dokumen perusahaan. Nasabah atau klien bisa saja membuat keputusan finansial berdasarkan informasi keliru tersebut, yang berujung pada sengketa hukum dan kerugian reputasi. Begitu pula pada implementasi AI di sektor pemerintahan, di mana informasi publik harus akurat. Kesalahan jawaban bot layanan publik bisa memicu protes massal.
Halusinasi juga menimbulkan risiko keamanan data. Dalam beberapa kasus, model bisa membocorkan informasi sensitif dari data pelatihan jika prompt dirancang dengan teknik manipulasi khusus. Bagi CTO atau IT manager, risiko ini berarti investasi infrastruktur AI harus disertai dengan kerangka kerja keamanan dan validasi yang ketat, bukan sekadar integrasi API standar.
Strategi Teknis untuk Mengurangi Halusinasi
Pendekatan paling efektif untuk membatasi halusinasi adalah memanfaatkan arsitektur Retrieval-Augmented Generation (RAG). Alih-alih membiarkan model menjawab dari ingatan statistiknya sendiri, sistem RAG memaksa AI untuk mencari informasi spesifik dari basis data internal perusahaan terlebih dahulu. Model kemudian menggunakan data tersebut sebagai konteks wajib untuk menyusun jawaban.
Dengan menambahkan basis pengetahuan sebagai sumber kebenaran tunggal, batasan operasional AI menjadi jauh lebih ketat. Anda bisa mempelajari lebih lanjut bagaimana arsitektur ini bekerja pada layanan [[rag-knowledge-base|layanan RAG Systems & Knowledge Base AI]] untuk melihat bagaimana sistem ini dirancang untuk pencarian informasi cerdas. Pendekatan ini juga bisa dikombinasikan dengan sistem [[conversational-ai|conversational AI]] untuk menjaga konsistensi jawaban di berbagai channel.
Selain RAG, ada beberapa pendekatan teknis lain yang umum diterapkan:
- Tuning parameter output: Menurunkan nilai temperature pada model membuat jawaban lebih deterministik dan mengurangi tingkat kreativitas atau pengarahan kata acak.
- Constraint prompt: Memberikan instruksi eksplisit agar AI hanya menjawab berdasarkan konteks yang diberikan, dan meminta AI menyatakan “tidak tahu” jika informasi tidak ditemukan.
- Human-in-the-loop validation: Untuk proses kritikal, output AI tetap harus melewati peninjauan staf manusia sebelum dikirim ke pengguna akhir atau dieksekusi oleh sistem lain.
- Guarding system: Mengimplementasikan lapisan middleware yang memfilter prompt masuk dan mencegah upaya manipulasi yang bisa memicu kebocoran data atau jawaban di luar konteks.
Desain Sistem AI yang Aman untuk Skala Enterprise
Membangun sistem AI untuk kebutuhan enterprise tidak berhenti di pemilihan model. Sebagai pengambil keputusan, Anda perlu memastikan vendor atau tim internal merancang arsitektur yang mampu mengelola risiko. Arsitektur sistem harus mengimplementasikan observasi dan pencatatan log secara terpusus. Setiap interaksi, prompt, dan jawaban AI harus dicatat untuk keperluan audit dan peningkatan kualitas di masa mendatang.
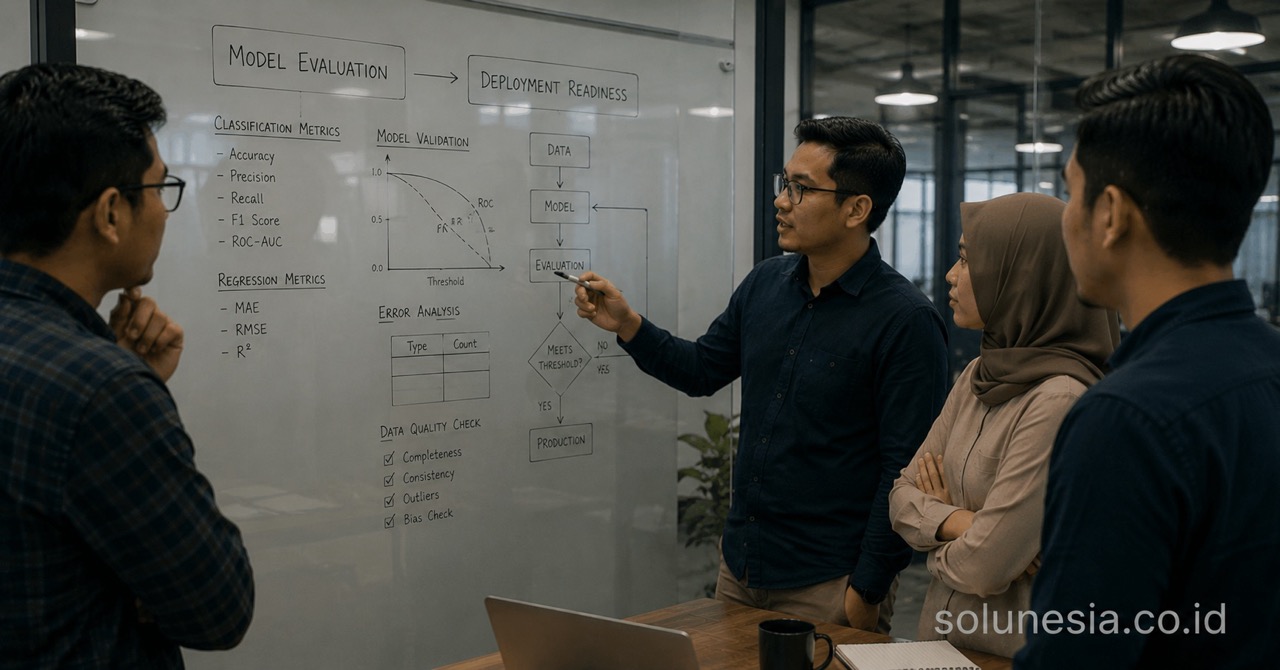
Evaluasi sistem juga perlu dilakukan berkala dengan metrik kuantitatif. Tim engineering dapat melakukan pengujian bertarget untuk melihat seberapa sering model mengarang informasi di luar konteks basis data. Tanpa pengujian terstruktur, mustahil untuk mengetahui apakah sistem benar-benar membantu atau justru diam-diam merugikan operasional.
Pengalaman dalam membangun sistem faktual berskala besar sangat krusial di tahap ini. Misalnya pada proyek KSP Finance yang bergerak di bidang fintech lintas batas, ketepatan ekstraksi data menggunakan OCR dan kepatuhan keamanan sistem harus diutamakan. Detail teknis seperti ini butuh ketelitian ekstra karena melibatkan dokumen sensitif. Solusi serupa untuk kebutuhan Anda bisa dieksplorasi melalui layanan [[ai-solutions|solusi AI untuk sistem enterprise]] yang fokus pada akurasi dan integrasi keamanan tingkat enterprise.
Kesimpulan
AI yang menghasilkan informasi keliru adalah masalah teknis bawaan yang tidak bisa dihilangkan 100%, tetapi risikonya bisa dikontrol hingga batas yang aman. Kunci utamanya adalah membatasi ruang gerak model menggunakan basis data perusahaan dan memvalidasi output untuk proses penting. Jika sistem enterprise Anda memerlukan integrasi AI yang aman dan minim risiko data fiktif, konsultasikan kebutuhan tersebut melalui laman kontak Solunesia.
FAQ
Apa itu halusinasi AI?
Halusinasi AI terjadi saat model bahasa menghasilkan jawaban yang terdengar meyakinkan namun secara faktual salah. Hal ini terjadi karena model bekerja dari pola statistik, bukan basis pengetahuan aktual.
Apakah risiko halusinasi bisa dihilangkan sepenuhnya?
Tidak bisa. Namun, risikonya dapat ditekan signifikan hingga tingkat yang aman untuk operasional melalui penerapan arsitektur RAG, penurunan kreativitas model, dan validasi otomatis.
Mengapa AI sering mengarang data ketika ditanya?
Model dirancang untuk selalu merangkai teks. Ketika dihadapkan pada kekosongan informasi atau instruksi yang ambigu, model akan memprediksi kata yang paling mungkin digunakan untuk mengisi kekosongan tersebut.
Bagaimana sistem RAG membantu mencegah halusinasi?
Sistem RAG memaksa AI untuk mencari dan memilih jawaban dari dokumen internal yang sudah divalidasi. AI dipatok untuk memproses dan menyimpulkan informasi dari data spesifik tersebut, bukan dari ingatan statistik model.
RelatedArticles
Further reading from other categories that may be relevant.
Tren AI di Indonesia 2026 dan Dampaknya bagi Bisnis
Pelajaran dari Implementasi KYC Berbasis AI pada Fintech Multinasional